Bài viết này được dịch từ bản tiếng Anh. Đọc bản gốc
Kỹ thuật harness cho agent: cải thiện AI mà không tinh chỉnh mô hình
Cách StaffOS thiết kế ngữ cảnh, công cụ và cơ chế thực thi khi giữ nguyên trọng số mô hình. Kết quả nghiên cứu công khai, tình huống giả lập và biểu đồ có thể tái tạo.
Harness, lớp phần mềm điều phối agent, có thể giúp một mô hình ngôn ngữ cố định thực hiện tác vụ tốt hơn bằng cách thay đổi ngữ cảnh mô hình nhận được, các công cụ mô hình có thể gọi và quy tắc thực thi. Tại StaffOS, chúng tôi xây dựng các cơ chế kiểm soát này trong môi trường thực thi của agent, đồng thời hỗ trợ việc rà soát và phê duyệt thay đổi đối với chỉ dẫn nghiệp vụ và cấu hình. Bài viết trình bày kiến trúc, những bằng chứng đã công bố làm cơ sở cho kiến trúc đó và phương pháp đo lường hiệu quả của từng thay đổi trong harness.
Số liệu trong bài lấy từ các nghiên cứu công khai. Các ví dụ nghiệp vụ đều là hư cấu; quy trình đánh giá sử dụng tình huống do kỹ sư biên soạn với bản ghi giả lập. Trọng số mô hình được giữ nguyên trong suốt quy trình này.
Tóm tắt
Agent phục vụ doanh nghiệp hoạt động xuyên suốt hội thoại, cơ sở dữ liệu và các dịch vụ bên ngoài. Lỗi thường bắt đầu ở ranh giới giữa các thành phần này: thiếu ngữ cảnh, kết quả công cụ không rõ ràng, trạng thái lỗi thời hoặc thông báo hành động đã thành công khi chưa có căn cứ. Kỹ thuật harness xử lý những lỗi đó bằng các đặc tả phần mềm rõ ràng. Chúng tôi xem xét ba thí nghiệm đã công bố về giao diện công cụ, tối ưu prompt và điều chỉnh ngữ cảnh, rồi trình bày cách áp dụng các ý tưởng này tại StaffOS. Chúng tôi xác định một quy trình đánh giá giữ nguyên mô hình, đo kết quả đã được xác minh và tính đến độ trễ, chi phí suy luận cùng tải vận hành. Số liệu đối chuẩn bên dưới lấy từ các nghiên cứu được trích dẫn. Kiến trúc và đặc tả đánh giá là đóng góp kỹ thuật của chúng tôi.
1. Harness của agent kiểm soát những gì
Harness của agent là lớp phần mềm bao quanh mô hình ngôn ngữ, quyết định mô hình được thấy thông tin gì, có thể yêu cầu hành động nào, các hành động đó được thực thi ra sao và khi nào công việc kết thúc. Phạm vi của harness bao gồm tổng hợp ngữ cảnh, truy xuất thông tin, đặc tả công cụ, quản lý trạng thái, giới hạn thực thi, quy tắc phê duyệt và phản hồi từ đánh giá.
Xét một yêu cầu đặt lịch hư cấu. Mô hình phải xác định dịch vụ được yêu cầu, lấy các khung giờ hợp lệ, hiểu thời gian được chọn, gửi yêu cầu đặt lịch và thông báo kết quả. Phần mềm xung quanh quyết định liệu các khung giờ còn hiệu lực, việc thử lại có tạo thêm lịch hẹn hay không và trạng thái trả về có cung cấp đủ thông tin để mô hình trả lời chính xác hay không.
Để phân tích, có thể biểu diễn agent như sau:
Kết quả của agent = F(mô hình, harness, tác vụ, môi trường)

Harness = {
  chỉ dẫn,
  lựa chọn ngữ cảnh,
  giao diện công cụ,
  chính sách thực thi,
  trạng thái làm việc và phản hồi từ đánh giá
}
Thay đổi harness làm thay đổi điều kiện hoạt động của mô hình. Vì vậy, một phép so sánh có giá trị cần giữ nguyên mô hình và môi trường, đồng thời xác định rõ phần harness được thay đổi. Nếu đổi mô hình, tăng số lần thử và sửa công cụ cùng lúc, sẽ khó xác định yếu tố nào tạo ra kết quả.
Chúng tôi chia thay đổi thành ba đơn vị:
- Sửa đổi prompt hoặc playbook: thay đổi chỉ dẫn dùng cho một quyết định cụ thể. Playbook là tài liệu hướng dẫn trình tự xử lý nghiệp vụ.
- Sửa đổi đặc tả công cụ: thay đổi các hành động có thể thực hiện hoặc thông tin mà hành động trả về.
- Sửa đổi môi trường thực thi: thay đổi cơ chế truy xuất, tổng hợp ngữ cảnh, giới hạn thực thi hoặc xử lý trạng thái.
Mỗi đơn vị có dạng lỗi riêng và cần các ca kiểm thử riêng.
2. Kết quả đã công bố khi giữ nguyên trọng số mô hình
Các nghiên cứu trong phần này xem xét những tác vụ và thước đo khác nhau. Mỗi phép so sánh giữ nguyên mô hình triển khai trong phạm vi thí nghiệm của mình. Các giá trị cung cấp bằng chứng cho từng cơ chế cụ thể; gộp chúng thành một giá trị trung bình sẽ che khuất điều kiện thí nghiệm.
Giao diện công cụ: FrogNano
Kim và cộng sự báo cáo tỷ lệ giải quyết trên SWE-bench Verified như sau khi thay R2E-Gym bằng harness Leaf của họ. Leaf thay đổi đồng thời giao diện công cụ, chỉ dẫn và cách kết thúc thực thi. 1
| Mô hình giữ nguyên | R2E-Gym | Leaf | Mức thay đổi tuyệt đối |
|---|---|---|---|
| Qwen3.5-4B | 8.3% | 37.2% | +28.9 điểm phần trăm |
| MiniMax-M2.5 | 66.5% | 66.5% | 0.0 điểm phần trăm |
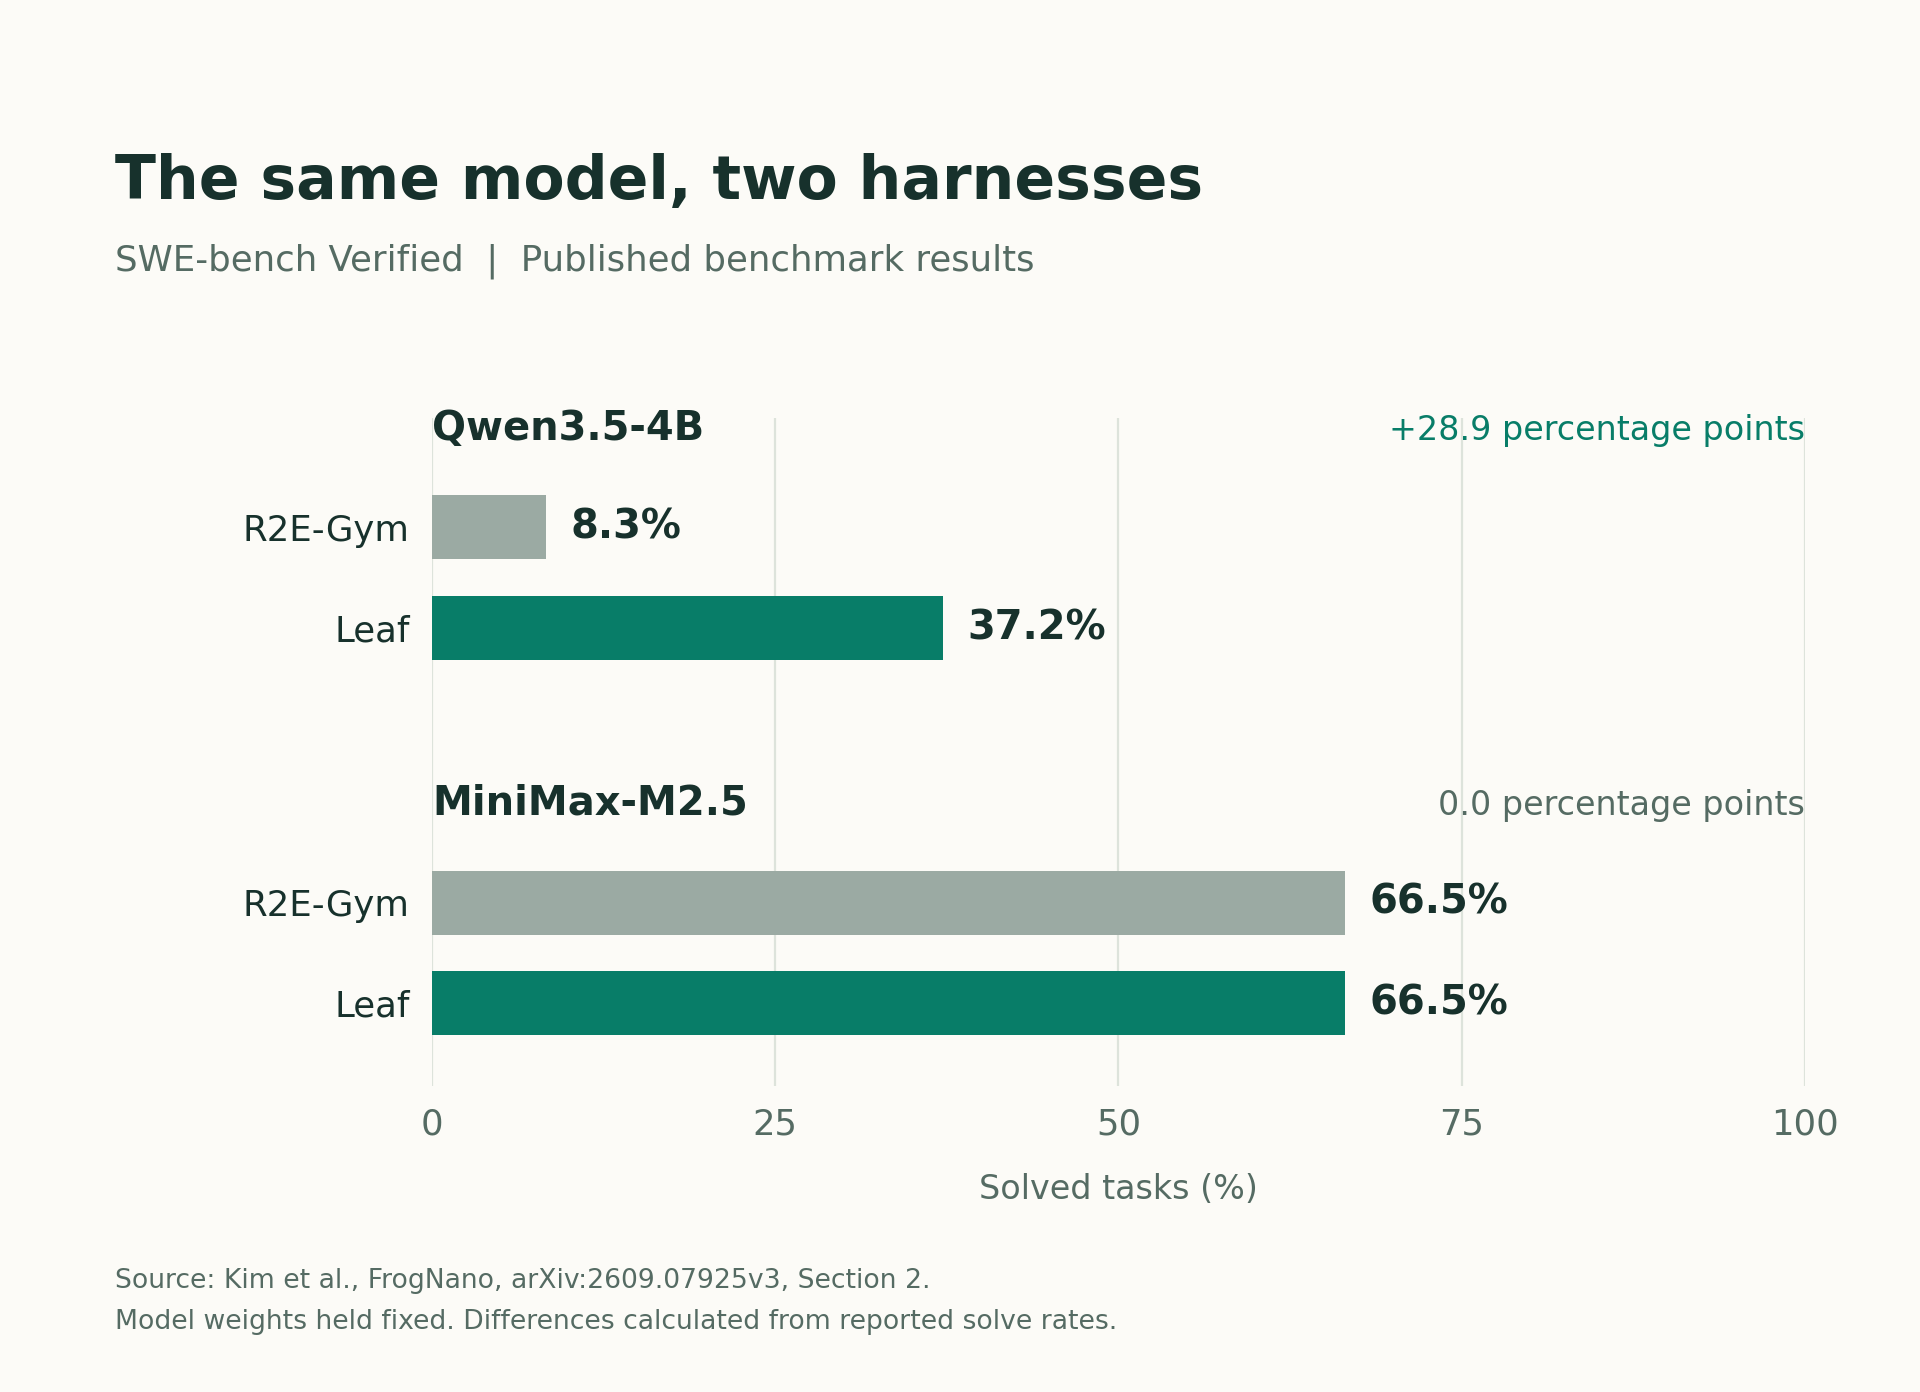
Hình 1. Phép so sánh harness được công bố trong FrogNano, Phần 2. Trục bắt đầu từ 0. Mô hình lớn hơn không có thay đổi.
Với Qwen3.5-4B, tỷ số là 37.2 / 8.3 = 4.48. Đây là kết quả của một mô hình cụ thể trong thí nghiệm về giao diện. Các kết quả học tăng cường ở phần sau của FrogNano có cập nhật trọng số và nằm ngoài phép so sánh này.
Tối ưu prompt: GEPA
GEPA sử dụng phản hồi từ quá trình thực thi để đề xuất và đánh giá các sửa đổi prompt. Trên HotpotQA, cấu hình Qwen3-8B cơ sở trong bài nghiên cứu đạt 42.33%, còn GEPA đạt 62.33%, tăng 20.00 điểm phần trăm. Thí nghiệm chính thức chấm theo mức khớp chính xác của câu trả lời. Trên IFBench, mức cải thiện tương ứng nhỏ hơn: từ 36.90% lên 38.61%. Các kết quả này cho thấy việc tối ưu prompt cần được đánh giá theo từng tác vụ. 2, 4
Điều chỉnh ngữ cảnh: ACE
ACE duy trì các mục playbook có cấu trúc thông qua quá trình tạo, tự đánh giá và chọn lọc. Với DeepSeek-V3.1 trên AppWorld, cấu hình ngoại tuyến sử dụng nhãn chuẩn cải thiện điểm trung bình được báo cáo từ 42.4% lên 59.4%, tăng 17.0 điểm phần trăm. Điểm trung bình này kết hợp tỷ lệ hoàn thành tác vụ và tình huống trên hai tập thông thường và thử thách. Cấu hình ngoại tuyến không sử dụng nhãn chuẩn đạt 57.2%. 3
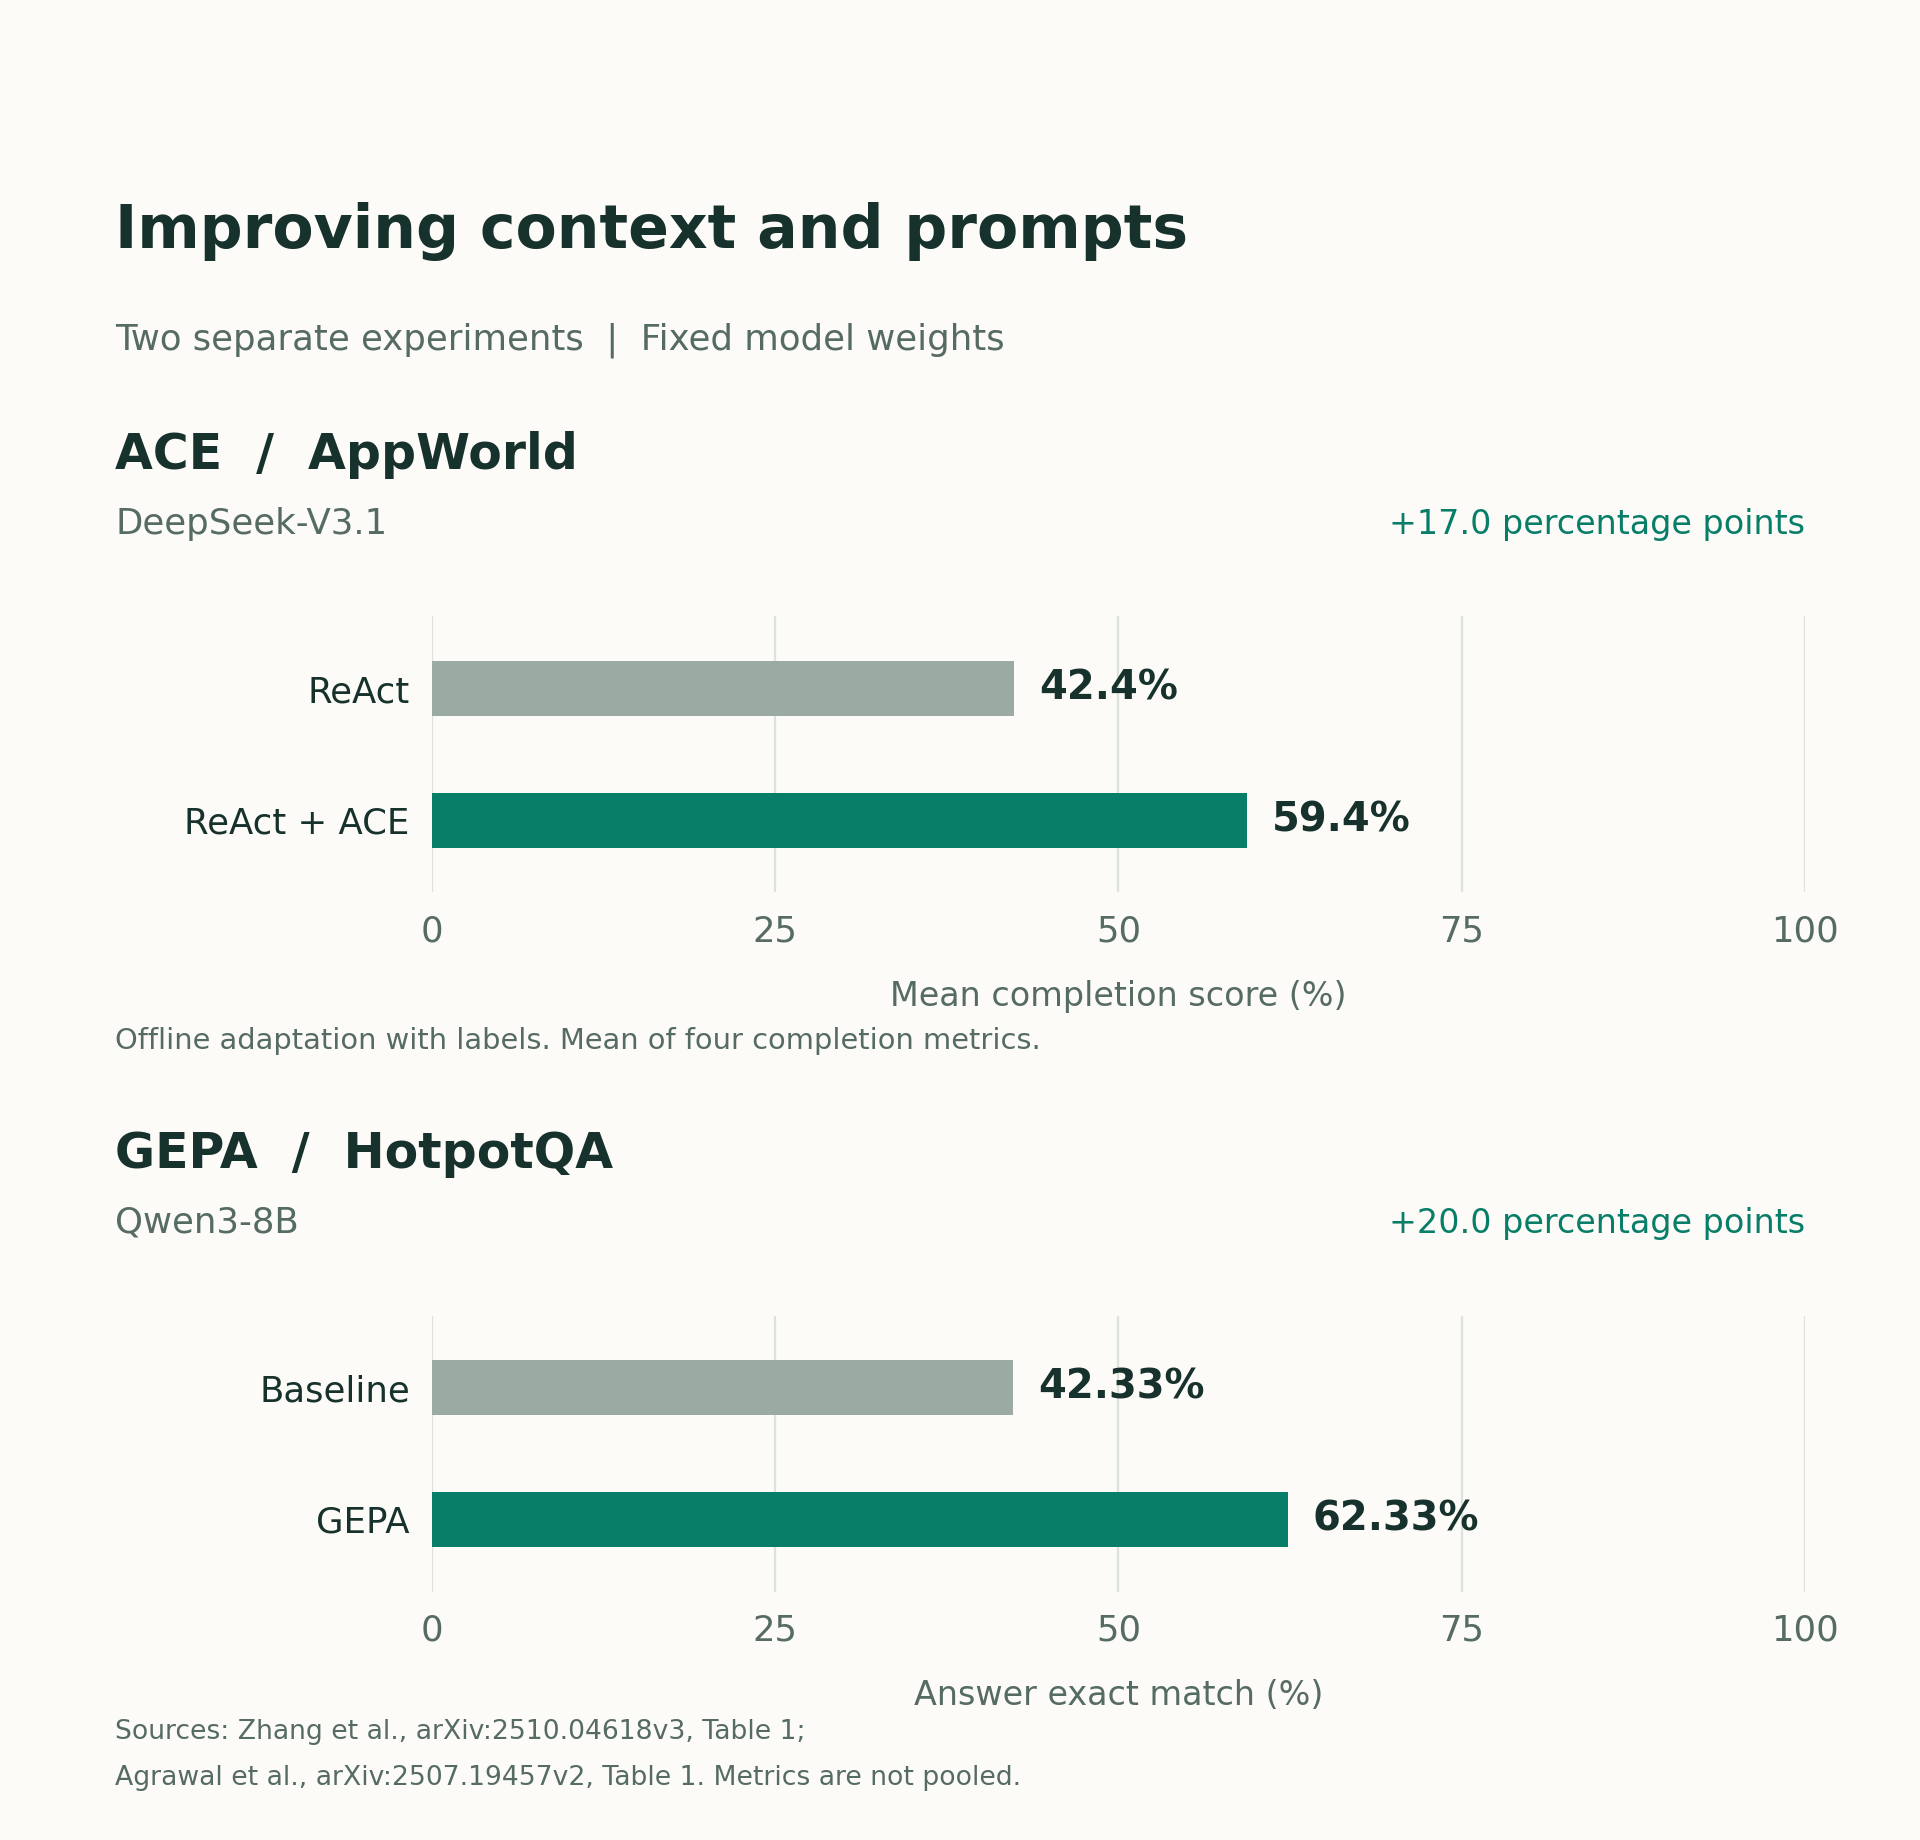
Hình 2. Các thí nghiệm riêng biệt từ Bảng 1 của ACE và Bảng 1 của GEPA. AppWorld sử dụng trung bình của bốn thước đo hoàn thành; HotpotQA sử dụng mức khớp chính xác của câu trả lời. Mỗi biểu đồ có điều kiện thí nghiệm riêng.
Câu hỏi thực tế với đội ngũ kỹ thuật là thay đổi đó giải quyết lỗi nào. Kết quả công cụ rõ ràng hơn có thể xử lý vấn đề về giao diện. Playbook có thể bổ sung quy trình còn thiếu. Thay đổi cơ chế truy xuất có thể đưa một thông tin sẵn có đến đúng bước cần dùng. Từng nhận định đều có thể được kiểm tra trực tiếp.
3. Cách chúng tôi tổ chức harness của StaffOS
StaffOS kết hợp truy xuất ngữ cảnh, công cụ có cấu trúc, thực thi có giới hạn và thay đổi cấu hình qua rà soát. Ranh giới giữa các thành phần này rất quan trọng vì một yêu cầu có thể đồng thời liên quan đến diễn giải ngôn ngữ, chính sách nghiệp vụ và thay đổi trạng thái. Chúng tôi đặt việc kiểm tra chính sách và trạng thái trong mã ứng dụng ở những nơi có thể biểu đạt các quy tắc đó một cách đáng tin cậy.
Ngữ cảnh: chọn thông tin cho quyết định hiện tại
Cơ chế truy xuất tri thức áp dụng phạm vi doanh nghiệp và agent, quy tắc về trạng thái hoạt động và hiệu lực, ngưỡng tương đồng và giới hạn số mục. Playbook hướng dẫn quy trình có đường truy xuất riêng. Cách này giúp môi trường thực thi phân biệt dữ kiện, chẳng hạn thông số sản phẩm, với quy trình, chẳng hạn các bước đánh giá khách hàng tiềm năng.
Lịch sử hội thoại cung cấp ngữ cảnh để xử lý yêu cầu đang diễn ra và được giới hạn dung lượng. Các vòng lặp dài của agent có thể thu gọn ngữ cảnh cũ, đồng thời giữ lại chỉ dẫn hệ thống và những lần trao đổi công cụ gần nhất. Các câu hỏi vận hành rất cụ thể: Nguồn liên quan có được chọn không? Nội dung có nằm trong giới hạn không? Có dữ kiện cần thiết nào bị loại bỏ khi thu gọn không? Cơ chế đó có thực sự chạy không?
Chỉ nhìn vào thiết lập ngữ cảnh thì chưa thể trả lời những câu hỏi này. Việc đánh giá cần cấu hình thực tế được áp dụng và các quan sát từ luồng đã thực thi.
Công cụ: xác định rõ hành động và kết quả
Công cụ có tên, mô tả và lược đồ tham số có cấu trúc. Bộ đăng ký công cụ áp dụng các điều kiện cho phép thực thi và đưa những thay đổi cấu hình thuộc diện phê duyệt vào trạng thái chờ duyệt. Mỗi công cụ tự kiểm tra các điều kiện tiên quyết về nghiệp vụ của mình.
Luồng đặt lịch tích hợp sẵn của chúng tôi minh họa đặc tả này:
appointment_offer_slots
  -> các khung giờ còn trống với thời gian bắt đầu chính xác

appointment_book(starts_at: selected_slot.starts_at)
  -> đã đặt lịch hẹn
  -> sử dụng lại lịch hẹn đã tồn tại
  -> slot_unavailable
Mô hình nhận các kết quả riêng biệt cho một lịch hẹn mới, một lần thử lại sử dụng lịch hẹn đã tồn tại và một xung đột khung giờ. Xung đột cho mô hình lý do để lấy danh sách khung giờ mới. Lịch hẹn đã tồn tại cung cấp một kết quả ổn định để thông báo.
Công cụ đặt lịch cũng phải xử lý được các yêu cầu đồng thời. Cách xử lý lần thử lại thuộc trách nhiệm của chính thao tác đó. Lặp lại một yêu cầu hợp lệ không được âm thầm tạo thêm lịch hẹn cho khách hàng.
Thực thi: giới hạn vòng lặp và kiểm tra thông báo hoàn tất
Môi trường thực thi giới hạn số vòng gọi công cụ và đưa ra chỉ dẫn kết thúc khi gần chạm giới hạn. Hệ thống cũng áp dụng các phép kiểm tra có mục tiêu đối với một số thông báo về hành động đã hoàn tất, bao gồm chuyển giao xử lý và thay đổi cấu hình. Các phép kiểm tra này đối chiếu bằng chứng từ công cụ hoặc trạng thái ứng dụng, sau đó thay thế thông báo chuyển giao thiếu căn cứ hoặc bổ sung giải thích thích hợp về trạng thái.
Phạm vi của mỗi phép kiểm tra hoàn tất phải rõ ràng. Quy tắc xác minh việc chuyển giao không thể xác nhận mọi phát biểu trong câu trả lời đều đúng. Mỗi nhóm thông báo bổ sung cần có bằng chứng và cách xử lý thất bại riêng.
Một thông báo hoàn tất cần có cùng bằng chứng với thao tác nghiệp vụ mà nó mô tả.
Cấu hình: rà soát và quản lý phiên bản thay đổi
StaffOS hỗ trợ thay đổi qua rà soát đối với năm loại cấu hình: persona, prompt, playbook, tri thức và thông tin sản phẩm. Các cơ chế này cho phép người vận hành quy định cách agent xử lý quy trình nghiệp vụ của doanh nghiệp mình. Thay đổi prompt được ghi theo phiên bản; hệ thống đánh giá hỗ trợ ca kiểm thử theo kịch bản và chạy thử với nhà cung cấp mô hình.
Mỗi cấu hình có người chịu trách nhiệm và mục đích riêng. Thông tin sản phẩm sai cần được sửa ở nguồn tri thức. Trình tự hành động bắt buộc thuộc về playbook. Phản hồi thành công không rõ ràng thuộc về đặc tả công cụ. Đưa cả ba vào prompt hệ thống sẽ khiến việc phân công trách nhiệm và kiểm thử khó hơn.
4. Xây dựng ca đánh giá từ đặc tả quy trình nghiệp vụ
Kỹ sư có thể viết ca đánh giá dựa trên yêu cầu quy trình, quy tắc nghiệp vụ và đặc tả công cụ. Mỗi ca xác định một quyết định, thông tin có sẵn tại thời điểm đó và kết quả mong đợi. Với tác vụ làm thay đổi trạng thái, ca kiểm thử còn quy định những bản ghi phải tồn tại sau khi thực thi.
Đặc tả ca đánh giá cần các trường sau:
| Trường | Nội dung cần có |
|---|---|
| Điểm quyết định | Tin nhắn giả lập hoặc kết quả công cụ mô phỏng dùng để bắt đầu kiểm thử |
| Ngữ cảnh có sẵn | Chỉ gồm thông tin có thể truy cập trước quyết định đó |
| Trạng thái ban đầu | Các bản ghi, quyền hạn, tình trạng còn trống và giả định về thời gian có liên quan |
| Hành vi mong đợi | Hành động bắt buộc, phản hồi chấp nhận được hoặc chuyển giao có lý do phù hợp |
| Hành vi bị cấm | Ghi trùng, hành động không được phép hoặc thông báo thành công thiếu căn cứ |
| Kiểm tra kết quả | Phép kiểm tra xác định khi có thể; nếu không, dùng bộ tiêu chí đã được rà soát |
| Thông tin nguồn | Nhóm tình huống, tham chiếu đặc tả và nguồn gốc dữ liệu kiểm thử |
| Thông tin phiên bản | Phiên bản mô hình, harness, prompt, công cụ, dữ liệu kiểm thử và bộ chấm điểm |
Với một ca đặt lịch giả lập, hãy thiết lập tình huống khung giờ đã chọn trở nên không còn trống trước lệnh gọi đặt lịch. Ca kiểm thử kiểm tra xem agent có thông báo xung đột và đưa ra lựa chọn thay thế hay không. Câu chữ mong đợi có thể khác nhau. Ràng buộc nghiệp vụ giữ nguyên: câu trả lời không được mô tả một lịch hẹn không tồn tại.
Các biến thể có kiểm soát giúp phát hiện lỗi ở những tình huống gần nhau. Cùng một ca có thể thay đổi cách diễn đạt ngày, mô phỏng hết thời gian chờ hoặc lặp lại yêu cầu sau khi đã ghi thành công. Mỗi biến thể cần trạng thái ban đầu hợp lệ và kết quả mong đợi đã được kiểm tra. Giữ các biến thể của một tình huống trong cùng một tập đánh giá để tránh một ca gần như giống hệt xuất hiện cả ở giai đoạn phát triển lẫn kiểm thử cuối cùng.
Chấm điểm câu trả lời và trạng thái kết quả riêng biệt. Một câu trả lời rõ ràng hơn vẫn có thể mô tả hành động đã thất bại. Một lịch hẹn kiểm thử được tạo thành công vẫn có thể đi kèm thông báo xác nhận khó hiểu. Ca đánh giá cần kiểm tra cả hai.
Tạo dữ liệu kiểm thử bằng tin nhắn, mã định danh và bản ghi nghiệp vụ hư cấu. Ghi lại nguồn gốc của chúng; không đưa bản chép hội thoại thực tế, mã tài khoản, thông tin xác thực và tài liệu riêng tư vào dữ liệu kiểm thử. Các ví dụ và tài liệu tải xuống đi kèm bài viết chỉ chứa thông tin nghiên cứu công khai và mô tả quy trình hư cấu.
5. Quy trình đánh giá một bản phát hành harness
Thí nghiệm harness so sánh hai cấu hình được xác định rõ trong điều kiện khởi đầu tương đương. Chúng tôi giữ nguyên định danh mô hình, thiết lập nhà cung cấp, đầu vào của từng ca và các giới hạn tài nguyên, rồi thay đổi một cơ chế hoặc một nhóm thay đổi được nêu rõ. Kết quả cần cho thấy ca nào cải thiện, ca nào giảm chất lượng và thay đổi đó tốn bao nhiêu chi phí.
Đặc tả đánh giá của chúng tôi gồm sáu bước:
- Cố định các ca và quy tắc chấm điểm. Xác định điều kiện thành công của tác vụ và các ràng buộc nghiệp vụ bắt buộc trước khi chạy cấu hình ứng viên.
- Nhóm các ví dụ có liên quan. Giữ mỗi tình huống giả lập và các biến thể trong cùng một tập. Dành các ca độc lập cho lần kiểm thử cuối cùng.
- Khai báo thay đổi được thử nghiệm. Ghi lại thay đổi về prompt, công cụ, truy xuất hoặc môi trường thực thi.
- Đặt lại trạng thái cho mỗi lần thử. Cả hai cấu hình nhận cùng tình trạng khung giờ, bản ghi và quyền hạn.
- Lặp lại trong giới hạn cố định. Báo cáo số lần thử, khoảng tin cậy và chênh lệch kết quả theo từng cặp; tính đến các lần chạy lặp của cùng một ca.
- Kiểm tra các trường hợp giảm chất lượng trước khi phát hành. Rà soát lỗi theo quy trình, ngôn ngữ và loại hành động, bao gồm cả những ca harness cũ đã xử lý đúng.
Giữ đúng thứ tự sự kiện trong từng mô phỏng. Tại một điểm quyết định, mô hình chỉ nhận thông tin có sẵn ở bước đó. Câu trả lời mong đợi, các tin nhắn mô phỏng về sau và trạng thái giao dịch cuối cùng thuộc phần kiểm tra của bộ đánh giá.
Các thước đo xác định cải thiện có ích
| Thước đo | Định nghĩa | Mục đích kỹ thuật |
|---|---|---|
| Tỷ lệ hoàn thành tác vụ đã xác minh | Số lần thử đạt kết quả đã quy định chia cho tổng số lần thử đủ điều kiện tính | Thước đo hiệu quả chính |
| Tỷ lệ vi phạm ràng buộc bắt buộc | Số lần thử có hành động bị cấm chia cho số lần thử đủ điều kiện tính | Điều kiện cho phép phát hành |
| Thông báo hoàn tất thiếu căn cứ | Số thông báo hành động được kiểm tra nhưng không có trạng thái hoặc xác nhận hỗ trợ chia cho tổng số thông báo hành động được kiểm tra | Đo một dạng lỗi cụ thể về độ tin cậy |
| Tỷ lệ lỗi công cụ | Số lần gọi công cụ thất bại chia cho tổng số lần gọi đã thử, phân theo loại lỗi | Phân biệt lỗi giao diện, chính sách và hạ tầng |
| Can thiệp của con người | Số lần thử cần người vận hành sửa chữa hoặc tiếp quản chia cho số lần thử đủ điều kiện tính | Đo gánh nặng vận hành |
| Độ trễ p50, p95 và p99 | Thời gian từ đầu đến cuối, ghi riêng thời gian chờ hàng đợi và thời gian của nhà cung cấp | Cho thấy hành vi thông thường và các trường hợp chậm |
| Chi phí cho mỗi lần thành công đã xác minh | Tổng chi phí đo được của tất cả các lần thử chia cho số lần thành công đã xác minh | Bao gồm chi phí của các lần thử thất bại |
| Độ bao phủ bằng chứng | Số lần thử có đủ các quan sát bắt buộc chia cho số lần thử được đếm độc lập | Cho biết phạm vi kết luận mà báo cáo có thể hỗ trợ |
Xác định điều kiện đưa vào phép tính trước khi thực thi. Các lần hết thời gian chờ, lỗi nhà cung cấp và bản ghi thực thi không đầy đủ vẫn phải nằm trong số ca đã thử. Kết quả đang chờ xử lý và chưa xác định vẫn cần được hiển thị. Phần thiếu dữ liệu sử dụng được báo cáo riêng với chi phí đã đo. Một báo cáo loại các lần chạy thất bại khỏi mẫu số có thể khiến một harness chậm hơn hoặc kém tin cậy hơn trông tốt hơn thực tế.
Điểm tổng hợp cần được phân tích theo từng nhóm. Cải thiện ở đặt lịch có thể che khuất sự suy giảm trong xử lý chuyển giao nếu chỉ nhìn giá trị trung bình chung. Các nhóm ngôn ngữ có lưu lượng lớn có thể che giấu sự suy giảm ở những nhóm nhỏ hơn. Báo cáo phát hành cần giữ rõ các khác biệt đó.
6. Hiệu năng và lưu trữ là một phần của thiết kế
Cải thiện harness tiêu tốn tài nguyên. Thêm ngữ cảnh tốn token đầu vào. Thêm vòng gọi công cụ làm tăng độ trễ và cơ hội phát sinh lỗi. Bản ghi đánh giá chi tiết tạo thêm thao tác ghi và chi phí lưu trữ. Đánh giá ngoại tuyến tiêu tốn ngân sách nhà cung cấp và năng lực xử lý nền. Các chi phí này cần được xem xét trong cùng đợt rà soát kỹ thuật với kết quả hoàn thành tác vụ.
Đặc tả hiệu năng xác định vị trí thực thi và giới hạn chi phí cho từng loại công việc:
| Công việc | Vị trí thực thi | Kiểm soát chi phí |
|---|---|---|
| Phân quyền, điều kiện tiên quyết và phê duyệt bắt buộc | Trước hành động có liên quan | Kiểm tra trạng thái ngắn gọn, sử dụng chỉ mục |
| Bộ đếm vận hành, thời gian và mã lỗi | Tại các điểm đã quy định trong quá trình thực thi | Giới hạn trường dữ liệu và thời gian ghi |
| Bản ghi chi tiết của đánh giá giả lập | Các lượt đánh giá được chọn | Lấy mẫu và giới hạn số byte cho mỗi lượt chạy |
| Tạo ca giả lập và phân tích kết quả kiểm thử | Tác vụ đánh giá chạy nền | Giới hạn lô, mức đồng thời và chi tiêu |
| So sánh các cấu hình ứng viên | Các lượt đánh giá tách biệt | Cố định số ca, số lần lặp và thời gian |
Hoạt động thu thập dữ liệu đo lường không bắt buộc cần có thời hạn. Bắt ngoại lệ cơ sở dữ liệu không ngăn được kết nối chậm hoặc chờ khóa làm chậm phản hồi cho khách hàng. Bản ghi phân quyền và phê duyệt bắt buộc có yêu cầu khác: nếu không ghi nhận được, hành động phụ thuộc phải bị chặn.
Các bộ đếm vận hành trong đặc tả này đo thời gian, trạng thái và mức sử dụng tài nguyên. Bản ghi đánh giá giả lập chứa đầu vào và đầu ra chi tiết của kiểm thử. Ước tính dung lượng lưu trữ từ số lượt đánh giá và kích thước bằng chứng được giữ lại:
Dung lượng bằng chứng đánh giá mỗi ngày
  = số lượt đánh giá được ghi lại mỗi ngày
  x số byte trung bình được giữ lại cho mỗi lượt ghi
Chi phí chỉ mục, bản sao và sao lưu được cộng thêm vào ước tính đó. Việc lấy mẫu theo tình huống cũng cần được đo: một tỷ lệ nhỏ các tình huống dài có thể chiếm phần lớn số lần gọi công cụ và dung lượng giữ lại.
Các bản chụp ngữ cảnh đánh giá lặp lại cần được chú ý riêng. Những vòng sau thường lặp lại tin nhắn giả lập và kết quả công cụ từ vòng trước. Các mảnh nội dung bất biến cùng danh sách tham chiếu có thứ tự có thể giảm trùng lặp, miễn là việc dựng lại ngữ cảnh và quản lý phiên bản dữ liệu kiểm thử vẫn đáng tin cậy.
7. Giới hạn của kỹ thuật harness
Harness có thể cung cấp dữ kiện còn thiếu, đưa ra hành động rõ ràng hơn và ngăn thao tác ghi không hợp lệ. Một số lỗi vẫn tồn tại sau các điều chỉnh đó. Chúng tôi phân loại riêng: yêu cầu tác vụ không rõ, thiếu dữ liệu nghiệp vụ, tích hợp không khả dụng và lỗi suy luận dù đã có đủ ngữ cảnh cùng công cụ hoạt động. Cách khắc phục phụ thuộc vào từng nhóm.
Các kết quả đối chuẩn đã công bố cũng có giới hạn. Lập trình, trả lời câu hỏi và tự động hóa ứng dụng dùng những tiêu chí thành công khác nhau. Quy trình nghiệp vụ của chúng tôi còn có chính sách riêng của từng doanh nghiệp, quyết định của con người và hệ thống bên ngoài với trạng thái thay đổi theo thời gian. Các thí nghiệm cho thấy thay đổi harness có thể tạo tác động đáng kể; đánh giá trong từng môi trường triển khai mới xác định được mức cải thiện cho một quy trình cụ thể.
Vì vậy, một bản phát hành vào môi trường thực tế cần cả bằng chứng về kết quả lẫn bằng chứng về vận hành. Tác vụ phải thành công theo các quy tắc đã công bố, còn chi phí, độ trễ và cách xử lý thất bại phải phù hợp với dịch vụ mà nó hỗ trợ.
Kết luận
Kỹ thuật harness cho chúng tôi những điểm cụ thể để cải thiện agent: dữ kiện agent nhận được, quy trình agent tuân theo, hành động agent có thể yêu cầu và các phép kiểm tra xung quanh những hành động đó. StaffOS sử dụng cấu trúc này để hỗ trợ cấu hình nghiệp vụ qua rà soát và các cơ chế kiểm soát thực thi rõ ràng.
Với mỗi thay đổi, quy trình đánh giá xác định lỗi, tái tạo quyết định trong một ca có kiểm soát và so sánh harness đã sửa đổi trong khi giữ nguyên mô hình. Quyết định phát hành xét đến thành công, các trường hợp giảm chất lượng, độ trễ và chi phí. Ca kiểm thử được giữ lại trong tập đánh giá để có thể phát hiện lỗi nếu nó tái diễn.
Tác giả và cách trích dẫn
Vin Lim là Giám đốc công nghệ của StaffOS. Anh làm việc về điều phối agent, tích hợp hệ thống doanh nghiệp, quản lý ngữ cảnh và đánh giá.
Cách trích dẫn đề xuất: Lim, V. (2026). Agent harness engineering: improving AI without fine-tuning. Tài liệu kỹ thuật StaffOS, phiên bản 1.1, ngày 17 tháng 9. https://staffos.xyz/blog/agent-harness-engineering
Tải trích dẫn BibTeX · Tải dữ liệu đối chuẩn và URL nguồn · Hình 1 ở định dạng SVG · Hình 2 ở định dạng SVG


Các biểu đồ tái hiện những giá trị được chọn từ nghiên cứu đã công bố. Chênh lệch điểm phần trăm được tính bằng phép trừ; tỷ số tỷ lệ giải quyết được tính bằng phép chia. Các hình không gộp kết quả giữa các bộ đối chuẩn. Để tìm hiểu bối cảnh nghiệp vụ, xem các bài viết về đánh giá khách hàng tiềm năng và nghiên cứu thời gian phản hồi khách hàng tiềm năng.
Frequently asked questions
Harness của agent là gì? +
Harness của agent là phần mềm tổng hợp ngữ cảnh cho mô hình, cung cấp công cụ, thực thi hành động, quản lý trạng thái và xác định khi nào công việc hoàn tất. Harness cũng cung cấp bản ghi và quy trình đánh giá cần thiết để cải thiện cách agent hoạt động.
Có thể cải thiện hiệu quả của agent mà không tinh chỉnh mô hình không? +
Có. Thay đổi chỉ dẫn, cơ chế truy xuất, đặc tả công cụ, bộ nhớ hoặc quy tắc thực thi có thể giúp agent hoàn thành tác vụ tốt hơn trong khi vẫn giữ nguyên trọng số mô hình đang triển khai. Mức cải thiện phụ thuộc vào mô hình, quy trình nghiệp vụ và harness dùng làm mốc so sánh.
Kỹ thuật harness có đòi hỏi huấn luyện trên dữ liệu khách hàng không? +
Phương pháp trong bài giữ nguyên trọng số mô hình. Kỹ sư sửa đổi chỉ dẫn, giao diện công cụ và quy tắc thực thi, rồi đánh giá các thay đổi bằng tình huống nghiệp vụ giả lập. Bài viết sử dụng kết quả nghiên cứu công khai và ví dụ hư cấu. Bài không chứa hội thoại của khách hàng hoặc bản ghi người dùng.
Nên đo những gì khi đánh giá harness? +
Đo tỷ lệ hoàn thành tác vụ đã được xác minh, vi phạm chính sách, thông báo hoàn tất thiếu căn cứ, lỗi công cụ, mức can thiệp của con người, độ trễ và chi phí cho mỗi lần thành công đã được xác minh. Giữ nguyên mô hình và điều kiện đánh giá khi ước tính tác động của một thay đổi trong harness.
References
- [1] Kim, M., et al. FrogNano: Training a 4B Coding Agent via Online Task Synthesis. arXiv:2609.07925v3, 2026. Section 2.
- [2] Agrawal, L. A., et al. GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. arXiv:2507.19457v2, 2026. Table 1.
- [3] Zhang, Q., et al. Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models. arXiv:2510.04618v3, 2026. Table 1.
- [4] GEPA authors. Official HotpotQA experiment configuration and exact-match evaluator.
About the author
Vin Lim
Đồng sáng lập / CTO, StaffOS
Vin Lim là Giám đốc công nghệ của StaffOS. Công việc của anh bao gồm điều phối agent, tích hợp hệ thống doanh nghiệp, quản lý ngữ cảnh và xây dựng các hệ thống đánh giá, cải thiện agent AI.
Related reading
Thống kê thời gian phản hồi lead từ mọi nghiên cứu lớn từ 2007 đến 2026
Phần lớn bài viết trích nghiên cứu thời gian phản hồi lead với nguồn gắn sai. Chúng tôi đã kiểm lại mọi nghiên cứu lớn từ 2007 đến 2026 đối chiếu với bài báo gốc.
Speed-to-lead trong kỷ nguyên agent: đường cong HBR vẫn đúng, sàn giờ tính bằng giây.
Đường cong speed-to-lead của HBR năm 2011 vẫn đúng, nhưng thời gian phản hồi trung vị của ngành đã tệ đi. Đây là điều AI SDR thay đổi và vì sao sàn giờ tính bằng giây.
Agent AI khiến drip cadence trở nên lỗi thời. Nuôi dưỡng theo tín hiệu là cái thay thế nó.
Drip cadence được tạo ra khi cá nhân hóa rất đắt và chi phí gửi tin nhắn gần như bằng không. LLM đã đảo ngược nền kinh tế đó. Đây là lập luận cho nuôi dưỡng theo tín hiệu trong kỷ nguyên agent.