บทความนี้แปลจากต้นฉบับภาษาอังกฤษ อ่านต้นฉบับ
วิศวกรรม Agent Harness: เพิ่มประสิทธิภาพ AI โดยไม่ทำ fine-tuning
StaffOS ออกแบบบริบท เครื่องมือ และการควบคุมการทำงานอย่างไรโดยคงน้ำหนักโมเดลเดิม พร้อมผลวิจัยสาธารณะ กรณีทดสอบสังเคราะห์ และกราฟที่สร้างซ้ำได้
Agent harness หรือซอฟต์แวร์ควบคุมการทำงานของเอเจนต์ สามารถเพิ่มประสิทธิภาพการทำงานของโมเดลภาษาตัวเดิมได้ด้วยการเปลี่ยนบริบทที่โมเดลได้รับ เครื่องมือที่เรียกใช้ได้ และกฎที่ควบคุมการดำเนินงาน ที่ StaffOS เราสร้างการควบคุมเหล่านี้ไว้ในระบบรันเอเจนต์ และรองรับการแก้ไขคำสั่งทางธุรกิจและการตั้งค่าที่ผ่านการตรวจทาน บทความนี้อธิบายสถาปัตยกรรม หลักฐานจากงานวิจัยที่เผยแพร่แล้ว และวิธีวัดว่าการเปลี่ยน harness ช่วยให้งานดีขึ้นหรือไม่
ตัวเลขในบทความมาจากผลวิจัยที่เผยแพร่ต่อสาธารณะ ตัวอย่างเวิร์กโฟลว์เป็นเรื่องสมมติ และระเบียบวิธีประเมินใช้สถานการณ์ที่วิศวกรเขียนขึ้นพร้อมระเบียนข้อมูลสังเคราะห์ น้ำหนักโมเดลคงเดิมตลอดการประเมินตามระเบียบวิธีนี้
บทคัดย่อ
เอเจนต์สำหรับธุรกิจทำงานเชื่อมระหว่างบทสนทนา ฐานข้อมูล และบริการภายนอก ความล้มเหลวมักเริ่มที่รอยต่อเหล่านี้ เช่น บริบทไม่ครบ ผลลัพธ์จากเครื่องมือกำกวม สถานะล้าสมัย หรือการอ้างว่าดำเนินการสำเร็จโดยไม่มีหลักฐาน วิศวกรรม harness จัดการปัญหาเหล่านี้ด้วยข้อกำหนดการทำงานของซอฟต์แวร์ที่ชัดเจน เราศึกษาการทดลองที่เผยแพร่แล้วสามงาน ซึ่งครอบคลุมอินเทอร์เฟซเครื่องมือ การปรับปรุงพรอมป์ต์ และการปรับบริบท จากนั้นอธิบายการประยุกต์แนวคิดเหล่านี้กับ StaffOS เรากำหนดระเบียบวิธีประเมินที่คงโมเดลเดิม วัดผลลัพธ์ที่ตรวจสอบได้ และคำนึงถึงเวลาแฝง ต้นทุนการอนุมาน และภาระการดำเนินงาน ตัวเลขเกณฑ์เปรียบเทียบด้านล่างมาจากงานวิจัยที่อ้างอิง ส่วนที่เรานำเสนอในเชิงวิศวกรรมคือสถาปัตยกรรมและข้อกำหนดการประเมิน
1. Agent harness ควบคุมอะไรบ้าง
Agent harness คือซอฟต์แวร์ที่ทำงานรอบโมเดลภาษา กำหนดว่าโมเดลเห็นอะไร ขอให้ดำเนินการใดได้บ้าง การดำเนินการนั้นเกิดขึ้นอย่างไร และงานสิ้นสุดเมื่อใด ขอบเขตครอบคลุมการประกอบบริบท การค้นคืนข้อมูล ข้อกำหนดการทำงานของเครื่องมือ การจัดการสถานะ ขีดจำกัดการดำเนินงาน กฎการอนุมัติ และผลตอบกลับจากการประเมิน
ลองพิจารณาคำขอนัดหมายสมมติ โมเดลต้องระบุบริการที่ต้องการ ขอช่วงเวลาว่างที่ใช้ได้ ตีความเวลาที่เลือก ส่งคำขอจอง และรายงานผล ซอฟต์แวร์ที่ทำงานร่วมกับโมเดลเป็นตัวกำหนดว่าช่วงเวลาว่างนั้นยังเป็นปัจจุบันหรือไม่ การลองใหม่จะสร้างการจองเพิ่มอีกครั้งหรือไม่ และสถานะที่ส่งกลับให้ข้อมูลเพียงพอสำหรับตอบได้ถูกต้องหรือไม่
ในการวิเคราะห์ เราเขียนองค์ประกอบของเอเจนต์ได้ดังนี้:
Agent outcome = F(model, harness, task, environment)

Harness = {
  instructions,
  context selection,
  tool interfaces,
  execution policy,
  working state and evaluation feedback
}
การเปลี่ยน harness คือการเปลี่ยนเงื่อนไขการทำงานของโมเดล การเปรียบเทียบที่ให้ข้อมูลใช้ได้จึงต้องคงโมเดลและสภาพแวดล้อมไว้ แล้วเปลี่ยนเฉพาะส่วนของ harness ที่ระบุชัดเจน หากเปลี่ยนโมเดล เพิ่มจำนวนครั้งที่ลอง และปรับเครื่องมือพร้อมกัน จะระบุได้ยากว่าอะไรทำให้ผลเปลี่ยนไป
เราแบ่งการเปลี่ยนแปลงเป็นสามหน่วย:
- การปรับพรอมป์ต์หรือคู่มือการทำงาน (playbook): เปลี่ยนคำสั่งที่ใช้กับการตัดสินใจเรื่องหนึ่ง
- การปรับข้อกำหนดการทำงานของเครื่องมือ: เปลี่ยนการดำเนินการที่ใช้ได้ หรือข้อมูลที่การดำเนินการนั้นส่งกลับ
- การปรับระบบรันเอเจนต์: เปลี่ยนการค้นคืนข้อมูล การประกอบบริบท ขีดจำกัดการดำเนินงาน หรือการจัดการสถานะ
แต่ละหน่วยมีรูปแบบความล้มเหลวต่างกัน และควรมีกลุ่มกรณีทดสอบของตนเอง
2. ผลวิจัยที่เผยแพร่แล้วโดยคงน้ำหนักโมเดลเดิม
งานวิจัยในส่วนนี้ศึกษางานและใช้ตัวชี้วัดต่างกัน แต่ละการเปรียบเทียบคงโมเดลที่ใช้งานไว้เหมือนเดิมภายในการทดลองของตน ตัวเลขเหล่านี้ใช้เป็นหลักฐานของกลไกเฉพาะได้ การนำมาหาค่าเฉลี่ยรวมจะบดบังเงื่อนไขการทดลองที่ต่างกัน
อินเทอร์เฟซเครื่องมือ: FrogNano
Kim และคณะรายงานอัตราการแก้โจทย์สำเร็จบน SWE-bench Verified ดังตารางด้านล่าง เมื่อเปลี่ยนจาก R2E-Gym มาใช้ Leaf harness ของทีม Leaf เปลี่ยนทั้งอินเทอร์เฟซเครื่องมือ คำสั่ง และพฤติกรรมการยุติงานร่วมกัน 1
| โมเดลที่คงเดิม | R2E-Gym | Leaf | ผลต่างสัมบูรณ์ |
|---|---|---|---|
| Qwen3.5-4B | 8.3% | 37.2% | +28.9 จุดเปอร์เซ็นต์ |
| MiniMax-M2.5 | 66.5% | 66.5% | 0.0 จุดเปอร์เซ็นต์ |
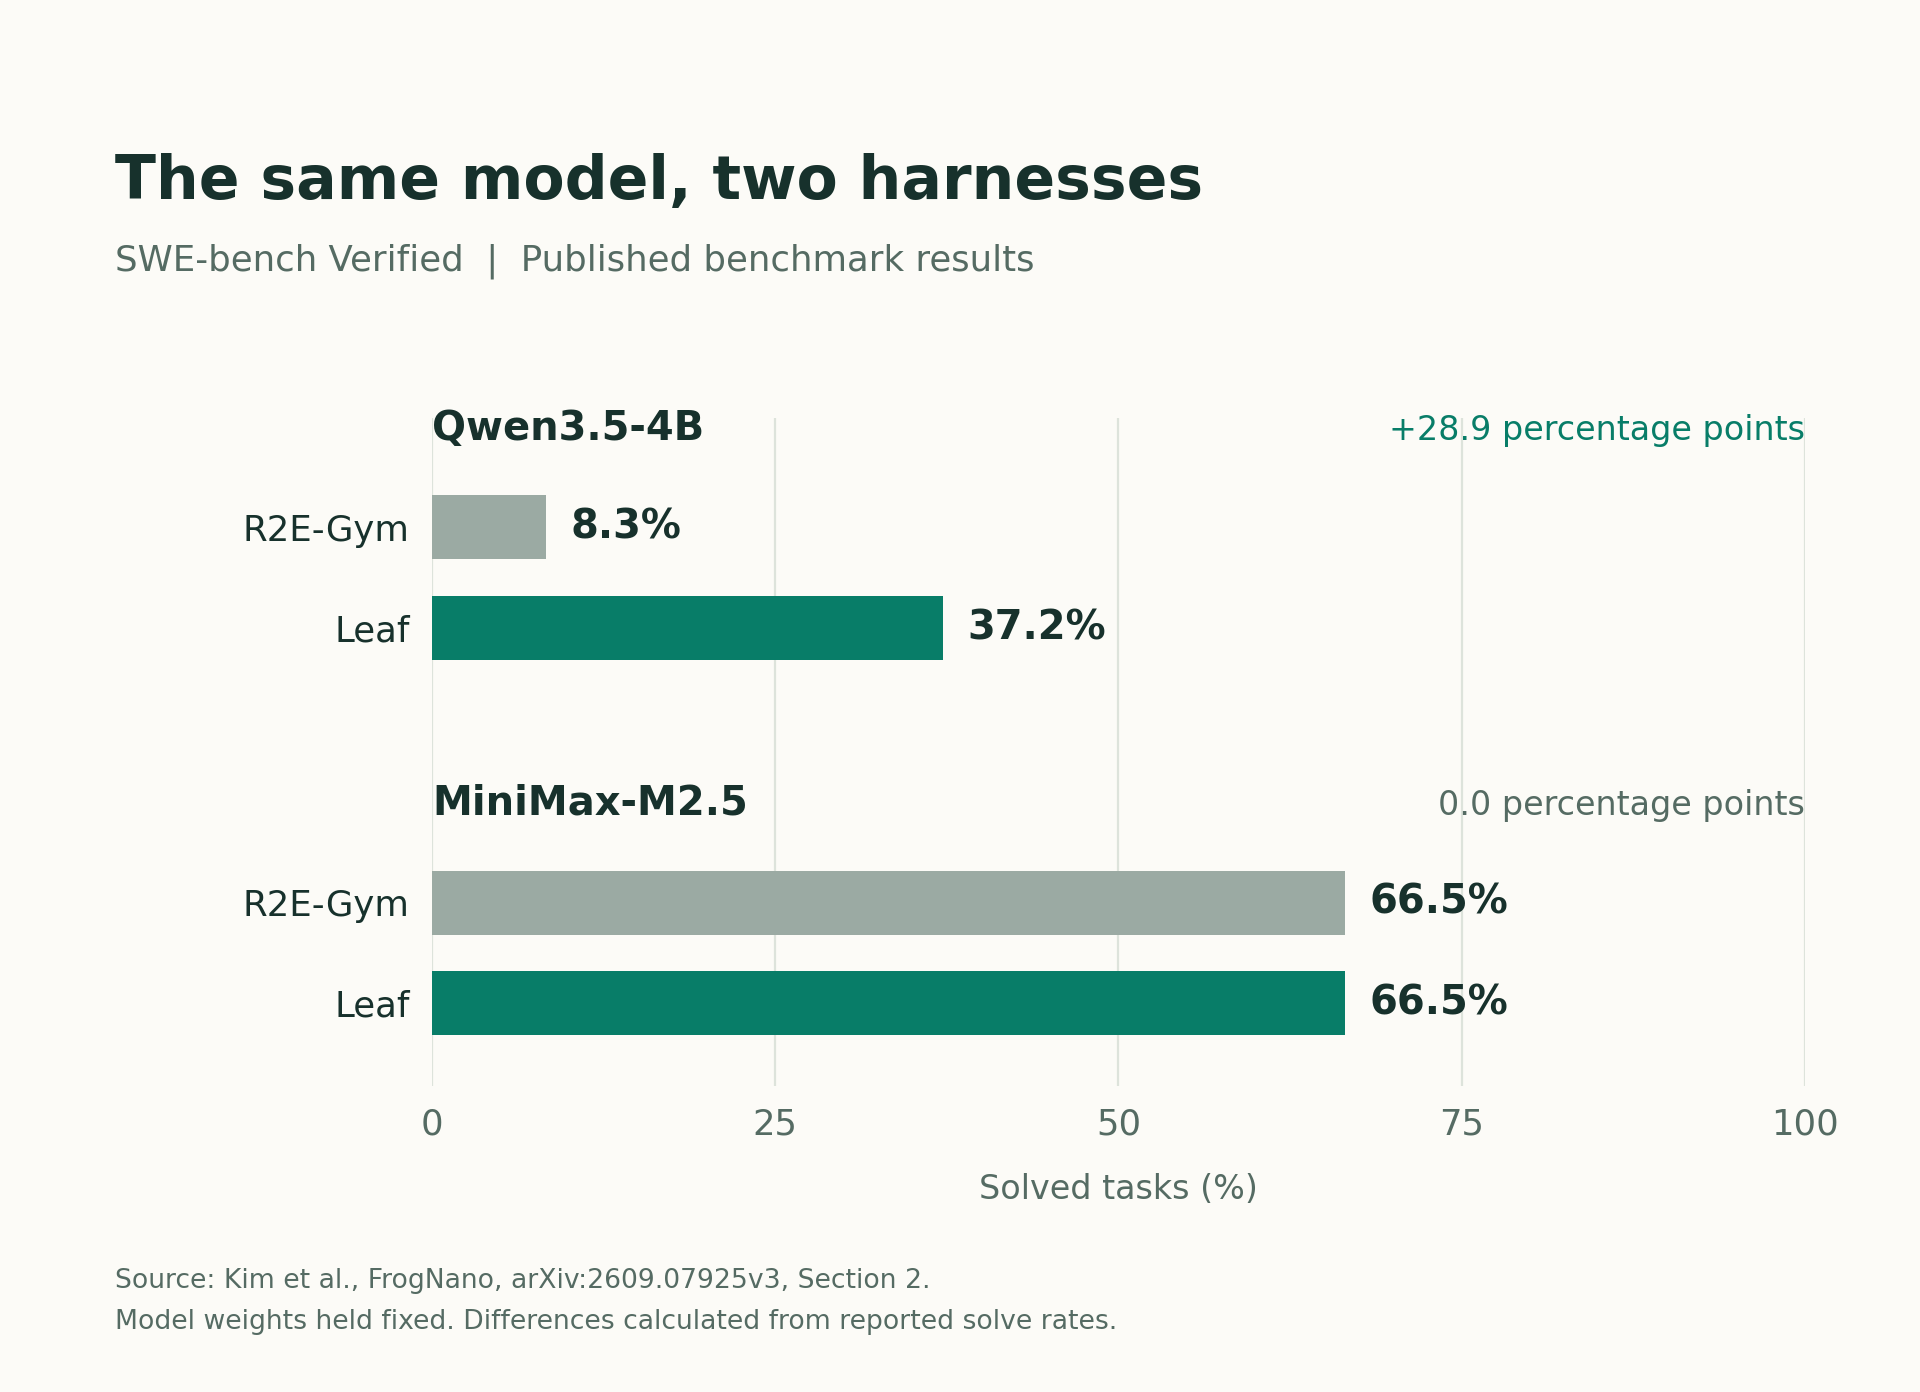
รูปที่ 1 การเปรียบเทียบ harness ที่เผยแพร่ใน FrogNano ส่วนที่ 2 แกนเริ่มที่ศูนย์ โมเดลขนาดใหญ่กว่าไม่มีการเปลี่ยนแปลงของผลลัพธ์
สำหรับ Qwen3.5-4B อัตราส่วนคือ 37.2 / 8.3 = 4.48 ผลนี้เจาะจงกับโมเดลดังกล่าวในการทดลองด้านอินเทอร์เฟซ ส่วนผลการเรียนรู้แบบเสริมกำลังในขั้นต่อมาของ FrogNano มีการปรับน้ำหนักโมเดล จึงอยู่นอกขอบเขตการเปรียบเทียบนี้
การปรับปรุงพรอมป์ต์: GEPA
GEPA ใช้ผลตอบกลับจากการทำงานเพื่อเสนอและประเมินการแก้ไขพรอมป์ต์ บน HotpotQA โมเดล Qwen3-8B ที่เป็นฐานเปรียบเทียบในงานวิจัยได้ 42.33% และ GEPA ได้ 62.33% เพิ่มขึ้น 20.00 จุดเปอร์เซ็นต์ การทดลองอย่างเป็นทางการใช้การให้คะแนนแบบคำตอบตรงกันทุกประการ (answer exact match) ส่วนบน IFBench ผลเพิ่มขึ้นน้อยกว่า คือจาก 36.90% เป็น 38.61% ผลเหล่านี้แสดงให้เห็นว่าการปรับปรุงพรอมป์ต์ต้องประเมินแยกตามงาน 2, 4
การปรับบริบท: ACE
ACE จัดเก็บรายการใน playbook อย่างมีโครงสร้าง ผ่านกระบวนการสร้าง ทบทวน และคัดกรอง เมื่อใช้ DeepSeek-V3.1 บน AppWorld การตั้งค่าแบบออฟไลน์ที่มีป้ายกำกับคำตอบจริง (ground-truth labels) เพิ่มค่าเฉลี่ยที่รายงานจาก 42.4% เป็น 59.4% หรือเพิ่มขึ้น 17.0 จุดเปอร์เซ็นต์ ค่าเฉลี่ยนี้รวมความสำเร็จระดับงานและระดับสถานการณ์ของทั้งชุดปกติและชุดท้าทาย ส่วนการตั้งค่าแบบออฟไลน์ที่ไม่มีป้ายกำกับคำตอบจริงได้ 57.2% 3
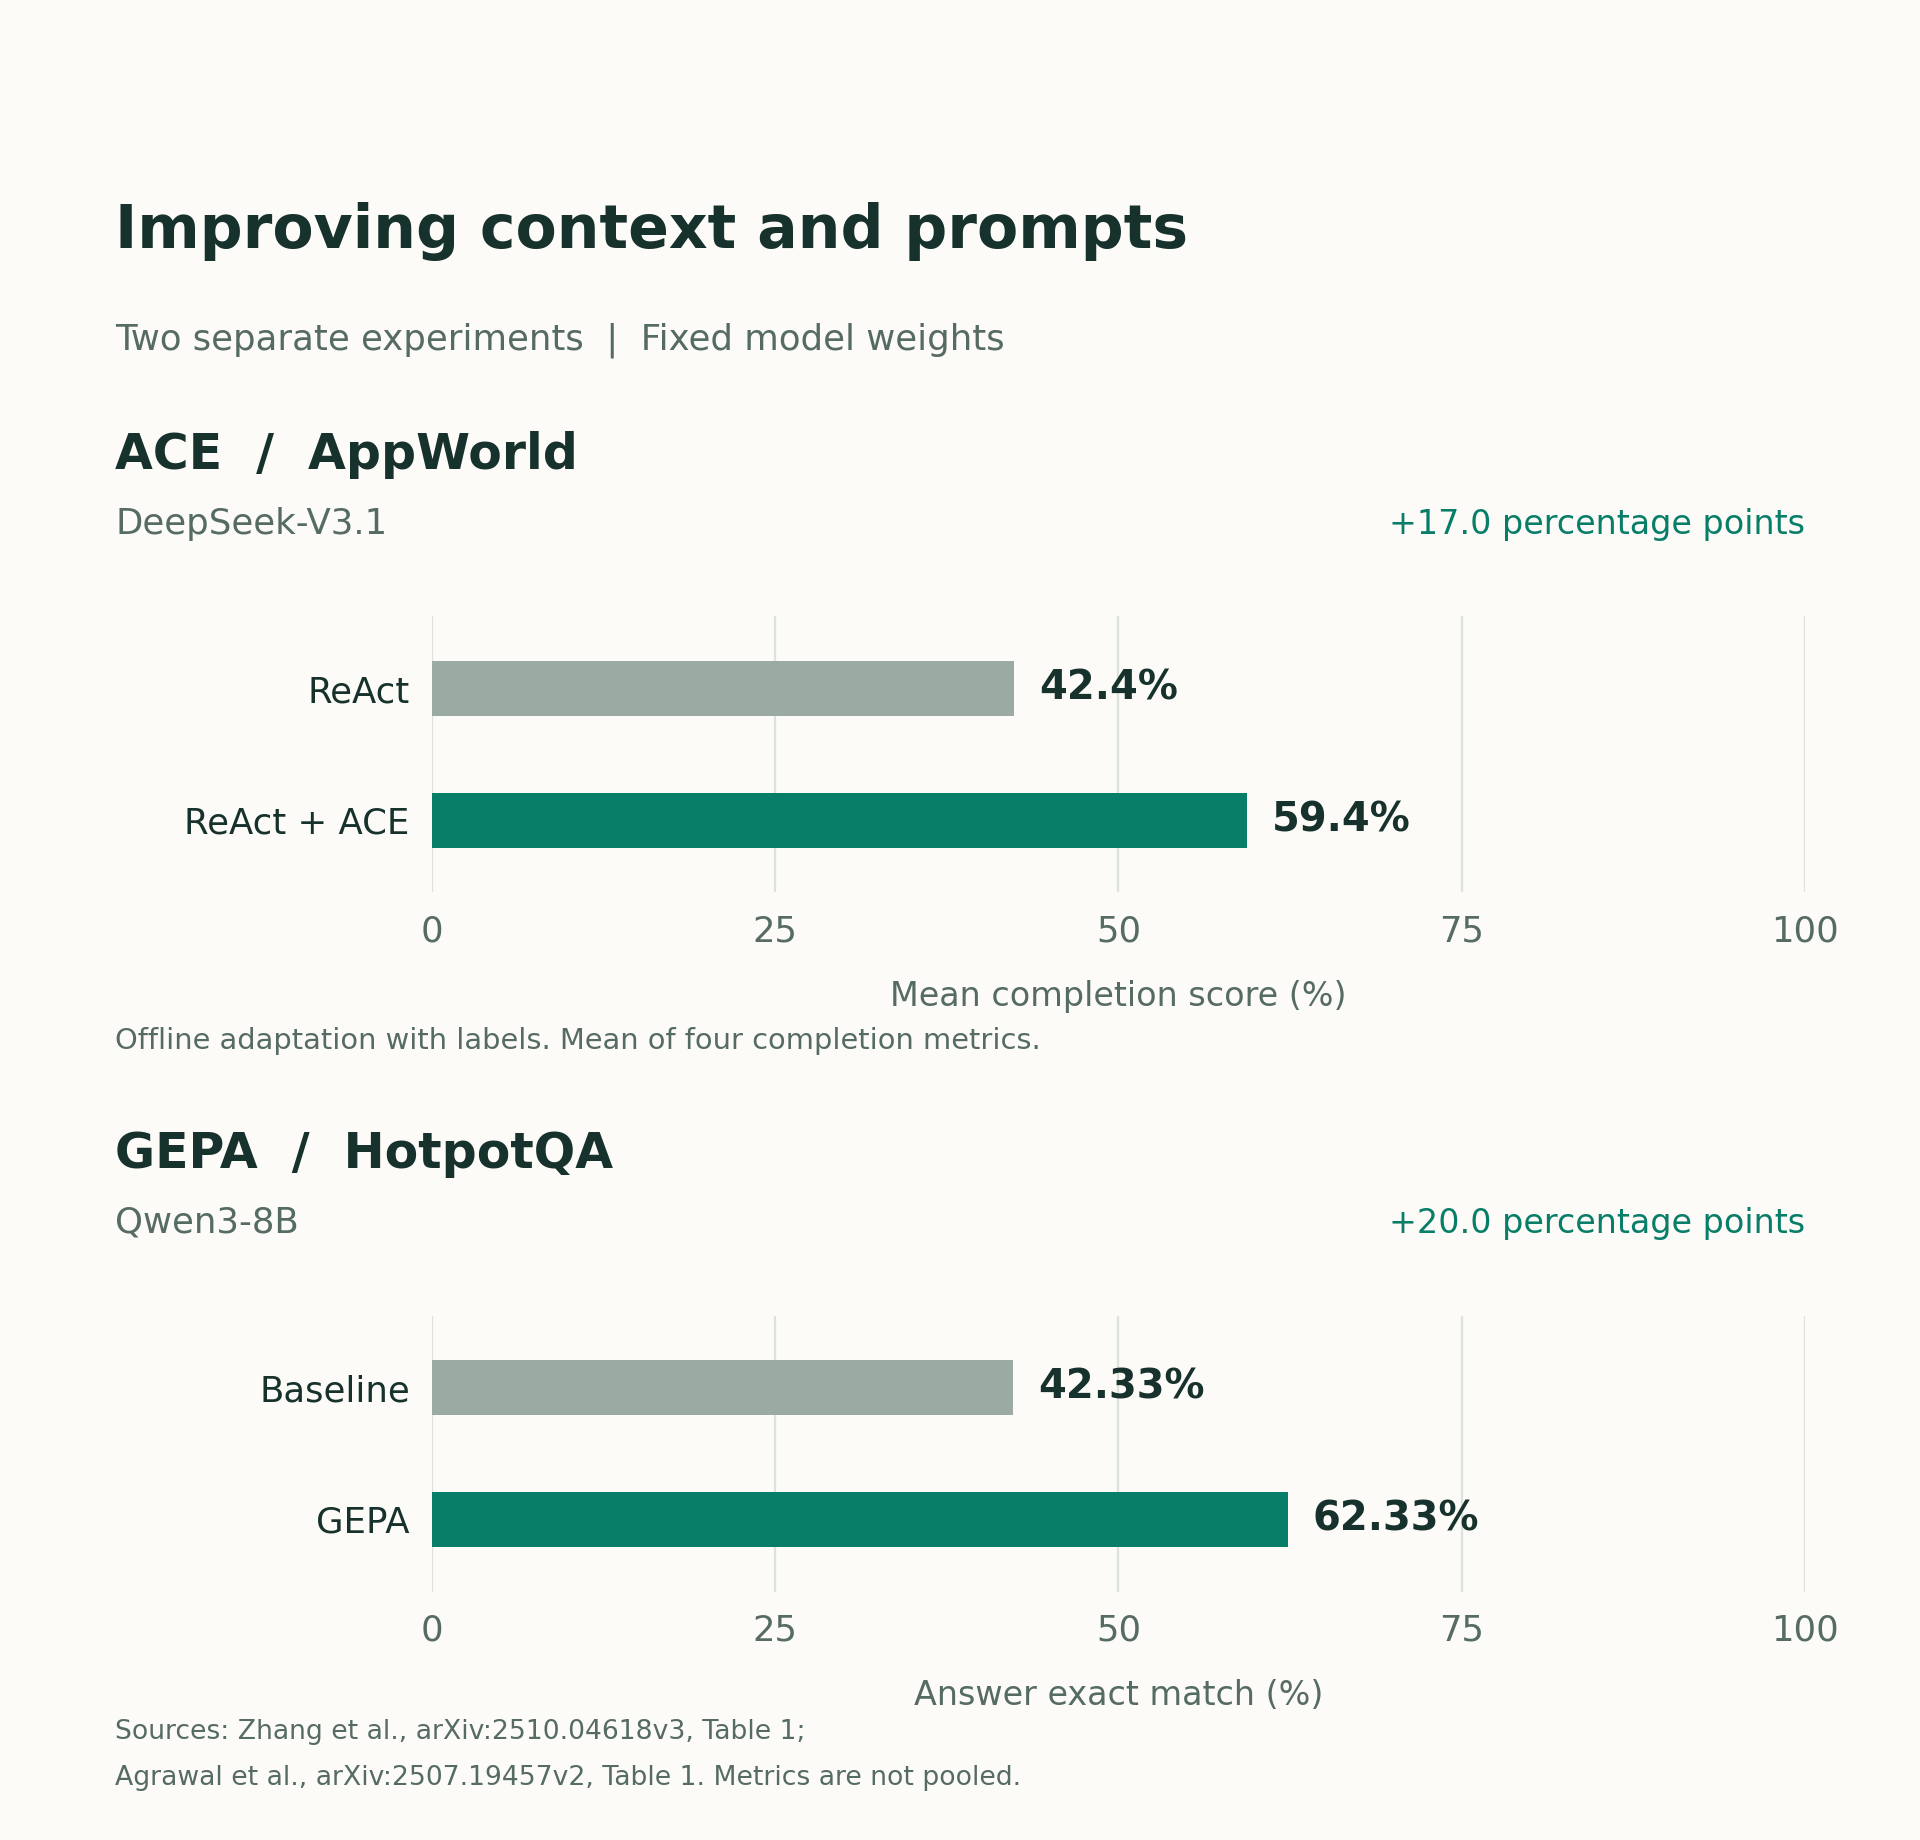
รูปที่ 2 การทดลองแยกกันจากตารางที่ 1 ของ ACE และตารางที่ 1 ของ GEPA AppWorld ใช้ค่าเฉลี่ยความสำเร็จจากตัวชี้วัดสี่รายการ ส่วน HotpotQA ใช้คำตอบตรงกันทุกประการ แต่ละแผงกราฟมีเงื่อนไขการทดลองของตนเอง
คำถามที่ทีมวิศวกรรมต้องตอบคือ การเปลี่ยนแปลงนั้นแก้ความล้มเหลวแบบใด ผลลัพธ์จากเครื่องมือที่ชัดเจนขึ้นอาจแก้ปัญหาอินเทอร์เฟซได้ Playbook อาจเติมขั้นตอนที่ขาดไป การเปลี่ยนวิธีค้นคืนข้อมูลอาจทำให้ข้อเท็จจริงที่มีอยู่แล้วปรากฏในขั้นตอนที่ต้องใช้ เราทดสอบข้ออ้างแต่ละข้อได้โดยตรง
3. โครงสร้าง harness ของ StaffOS
StaffOS รวมการค้นคืนบริบท เครื่องมือที่มีโครงสร้าง การดำเนินงานภายใต้ขีดจำกัด และการเปลี่ยนการตั้งค่าที่ผ่านการตรวจทาน รอยต่อระหว่างองค์ประกอบเหล่านี้มีความสำคัญ เพราะคำขอเดียวอาจเกี่ยวข้องทั้งกับการตีความภาษา นโยบายธุรกิจ และการเปลี่ยนสถานะ เราจึงให้โค้ดแอปพลิเคชันตรวจสอบนโยบายและสถานะในทุกส่วนที่เขียนเป็นกฎได้อย่างเชื่อถือได้
บริบท: เลือกข้อมูลให้เหมาะกับการตัดสินใจปัจจุบัน
การค้นคืนความรู้ของเราใช้ขอบเขตของธุรกิจและเอเจนต์ กฎสถานะการใช้งานและช่วงเวลาที่ข้อมูลมีผล เกณฑ์ความคล้ายคลึง และจำนวนรายการสูงสุด ส่วน playbook ที่อธิบายขั้นตอนใช้เส้นทางค้นคืนแยกต่างหาก ทำให้ระบบแยกข้อเท็จจริง เช่น ข้อมูลจำเพาะของสินค้า ออกจากขั้นตอนปฏิบัติ เช่น ขั้นตอนคัดกรองลีดได้
ประวัติการสนทนาให้บริบทสำหรับจัดการคำขอที่กำลังดำเนินอยู่ โดยมีงบประมาณบริบทกำกับ วงรอบเอเจนต์ที่ยาวสามารถย่อบริบทเก่า ขณะที่เก็บคำสั่งระบบและการเรียกเครื่องมือพร้อมผลลัพธ์ล่าสุดไว้ คำถามด้านการทำงานจึงตรวจสอบได้ชัดเจน: เลือกแหล่งข้อมูลที่เกี่ยวข้องหรือไม่? เนื้อหาใส่ในบริบทได้ครบหรือไม่? การย่อบริบทตัดข้อเท็จจริงที่จำเป็นออกไปหรือไม่? กลไกนี้ได้ทำงานจริงหรือไม่?
ค่าตั้งค่าบริบทเพียงอย่างเดียวตอบคำถามเหล่านี้ไม่ได้ การประเมินต้องมีทั้งการตั้งค่าที่มีผลจริงและสิ่งที่สังเกตได้จากเส้นทางการทำงานที่เกิดขึ้น
เครื่องมือ: ระบุการดำเนินการและผลลัพธ์ให้ชัดเจน
เครื่องมือมีชื่อ คำอธิบาย และสคีมาพารามิเตอร์ที่มีโครงสร้าง ทะเบียนเครื่องมือบังคับใช้เงื่อนไขการดำเนินงาน และพักการเปลี่ยนการตั้งค่าที่เข้าเกณฑ์ไว้รออนุมัติ เครื่องมือแต่ละตัวตรวจเงื่อนไขล่วงหน้าทางธุรกิจของตนเอง
เวิร์กโฟลว์นัดหมายที่มีในระบบของเราแสดงข้อกำหนดนี้ได้ดังนี้:
appointment_offer_slots
  -> available slots with exact start times

appointment_book(starts_at: selected_slot.starts_at)
  -> booked appointment
  -> existing booking reused
  -> slot_unavailable
โมเดลได้รับผลลัพธ์ที่แยกกันชัดเจนระหว่างการจองใหม่ การลองซ้ำที่ใช้การจองเดิม และช่วงเวลาที่ไม่ว่างแล้ว ผลว่าช่วงเวลาไม่ว่างทำให้โมเดลมีเหตุผลที่จะขอข้อมูลเวลาว่างล่าสุด ส่วนผลที่พบการจองเดิมให้สถานะที่แน่นอนสำหรับรายงาน
เครื่องมือนัดหมายต้องรองรับคำขอที่เกิดขึ้นพร้อมกันด้วย พฤติกรรมเมื่อลองซ้ำต้องเป็นส่วนหนึ่งของการดำเนินการนั้นเอง การส่งคำขอที่ถูกต้องซ้ำต้องไม่ทำให้เกิดการจองเพิ่มให้ลูกค้าโดยไม่มีการแจ้ง
การดำเนินงาน: จำกัดวงรอบและตรวจคำกล่าวอ้างว่างานเสร็จ
ระบบรันเอเจนต์จำกัดจำนวนรอบการใช้เครื่องมือ และเพิ่มคำสั่งให้สรุปงานเมื่อใกล้ถึงขีดจำกัด นอกจากนี้ยังตรวจคำกล่าวอ้างบางประเภทเกี่ยวกับการดำเนินการที่เสร็จแล้วอย่างเจาะจง รวมถึงการส่งต่อเรื่องและการเปลี่ยนการตั้งค่า การตรวจเหล่านี้พิจารณาหลักฐานจากเครื่องมือหรือสถานะในแอปพลิเคชัน แล้วแทนที่คำกล่าวอ้างการส่งต่อที่ไม่มีหลักฐาน หรือเพิ่มคำชี้แจงสถานะที่เหมาะสม
ขอบเขตของการตรวจว่างานเสร็จควรชัดเจน กฎที่ตรวจยืนยันการส่งต่อเรื่องไม่สามารถรับรองว่าข้อความเชิงข้อเท็จจริงทุกข้อในคำตอบถูกต้อง คำกล่าวอ้างแต่ละกลุ่มที่เพิ่มเข้ามาต้องมีหลักฐานและพฤติกรรมเมื่อพบข้อผิดพลาดของตนเอง
การอ้างว่าดำเนินการเสร็จแล้วต้องใช้หลักฐานเดียวกับที่ใช้ยืนยันการดำเนินการทางธุรกิจนั้น
การตั้งค่า: ตรวจทานและจัดการเวอร์ชันของการเปลี่ยนแปลง
StaffOS รองรับการเปลี่ยนแปลงที่ผ่านการตรวจทานสำหรับการตั้งค่าห้าประเภท: บุคลิกของเอเจนต์ พรอมป์ต์ playbook ความรู้ และข้อมูลสินค้า การควบคุมเหล่านี้ช่วยให้ผู้ดูแลกำหนดวิธีที่เอเจนต์ควรจัดการเวิร์กโฟลว์ของธุรกิจ การแก้ไขพรอมป์ต์ใช้กลไกบันทึกที่จัดการเวอร์ชัน และระบบประเมินรองรับทั้งกรณีทดสอบที่เขียนสคริปต์ไว้และการรันทดสอบกับผู้ให้บริการโมเดล
การตั้งค่าแต่ละประเภทมีผู้รับผิดชอบและวัตถุประสงค์ของตนเอง ข้อมูลสินค้าที่ผิดต้องแก้ในแหล่งความรู้ ลำดับการดำเนินการที่จำเป็นต้องอยู่ใน playbook ผลตอบกลับความสำเร็จที่กำกวมต้องแก้ในข้อกำหนดของเครื่องมือ การนำทั้งสามเรื่องไปใส่ในพรอมป์ต์ระบบจะทำให้ระบุผู้รับผิดชอบและทดสอบได้ยากขึ้น
4. สร้างกรณีประเมินจากข้อกำหนดเวิร์กโฟลว์
วิศวกรสามารถเขียนกรณีประเมินจากข้อกำหนดเวิร์กโฟลว์ กฎธุรกิจ และข้อกำหนดของเครื่องมือ แต่ละกรณีระบุการตัดสินใจ ข้อมูลที่มีอยู่ ณ จุดนั้น และผลลัพธ์ที่คาดหวัง สำหรับงานที่เปลี่ยนสถานะ การทดสอบต้องระบุด้วยว่าหลังดำเนินการแล้วควรมีระเบียนใดอยู่บ้าง
ข้อกำหนดกรณีทดสอบต้องมีข้อมูลต่อไปนี้:
| ฟิลด์ | สิ่งที่กรณีทดสอบต้องระบุ |
|---|---|
| จุดตัดสินใจ | ข้อความสังเคราะห์หรือผลลัพธ์จากเครื่องมือจำลองที่ใช้เริ่มการทดสอบ |
| บริบทที่มีอยู่ | เฉพาะข้อมูลที่เข้าถึงได้ก่อนการตัดสินใจนั้น |
| สถานะเริ่มต้น | ระเบียน สิทธิ์ ความพร้อมใช้งาน และสมมติฐานเรื่องเวลาที่เกี่ยวข้อง |
| พฤติกรรมที่คาดหวัง | การดำเนินการที่จำเป็น คำตอบที่ยอมรับได้ หรือการส่งต่อที่มีเหตุผล |
| พฤติกรรมต้องห้าม | การเขียนข้อมูลซ้ำ การดำเนินการโดยไม่มีสิทธิ์ หรือการอ้างว่าสำเร็จโดยไม่มีหลักฐาน |
| การตรวจผลลัพธ์ | ข้อกำหนดตรวจสอบแบบให้ผลแน่นอนเมื่อทำได้ หรือเกณฑ์ให้คะแนนที่ผ่านการตรวจทาน |
| ที่มาของกรณี | กลุ่มสถานการณ์ เอกสารข้อกำหนดที่อ้างอิง และที่มาของชุดข้อมูลทดสอบ |
| ข้อมูลเวอร์ชัน | เวอร์ชันของโมเดล harness พรอมป์ต์ เครื่องมือ ชุดข้อมูลทดสอบ และตัวให้คะแนน |
สำหรับกรณีนัดหมายสังเคราะห์ ให้กำหนดว่าช่วงเวลาที่เลือกไว้กลายเป็นไม่ว่างก่อนเรียกจอง การทดสอบตรวจว่าเอเจนต์แจ้งปัญหาและเสนอทางเลือก ข้อความที่คาดหวังอาจเขียนได้หลายแบบ แต่เงื่อนไขธุรกิจยังคงเดิม: คำตอบต้องไม่ระบุว่ามีการจองที่ไม่ได้เกิดขึ้นจริง
กรณีแปรผันที่ควบคุมไว้ช่วยเปิดเผยความล้มเหลวที่เกี่ยวข้องกัน กรณีเดียวกันอาจเปลี่ยนถ้อยคำบอกวันที่ จำลองการหมดเวลารอ หรือส่งคำขอซ้ำหลังเขียนข้อมูลสำเร็จ แต่ละแบบต้องมีสถานะเริ่มต้นที่ถูกต้องและผลลัพธ์ที่คาดหวังซึ่งตรวจสอบแล้ว ให้จัดกรณีแปรผันของสถานการณ์เดียวกันไว้ในชุดประเมินเดียวกัน เพื่อไม่ให้กรณีที่แทบเหมือนกันปรากฏทั้งในชุดพัฒนาและชุดทดสอบสุดท้าย
ให้คะแนนคำตอบและสถานะที่เกิดขึ้นแยกกัน คำตอบที่ชัดเจนขึ้นยังอาจบรรยายการดำเนินการที่ล้มเหลว การจองในการทดสอบที่สำเร็จก็ยังอาจให้ข้อความยืนยันที่สับสนได้ กรณีทดสอบต้องตรวจทั้งสองด้าน
สร้างชุดข้อมูลทดสอบด้วยข้อความ ตัวระบุ และระเบียนธุรกิจที่แต่งขึ้น บันทึกที่มาและไม่นำบันทึกบทสนทนาจากระบบใช้งานจริง ตัวระบุบัญชี ข้อมูลรับรองการเข้าถึง หรือเอกสารส่วนตัวมาเป็นข้อมูลทดสอบ ตัวอย่างและไฟล์ดาวน์โหลดที่มาพร้อมบทความนี้มีเฉพาะข้อมูลวิจัยสาธารณะและคำอธิบายเวิร์กโฟลว์สมมติ
5. ระเบียบวิธีประเมินก่อนปล่อย harness รุ่นใหม่
การทดลอง harness เปรียบเทียบการตั้งค่าสองแบบที่ระบุชัดเจน ภายใต้เงื่อนไขเริ่มต้นที่เทียบเท่ากัน เราคงรุ่นโมเดล การตั้งค่าผู้ให้บริการ ข้อมูลนำเข้าของกรณีทดสอบ และงบประมาณไว้ จากนั้นเปลี่ยนกลไกเดียวหรือกลุ่มการเปลี่ยนแปลงที่ระบุขอบเขตชัดเจน ผลต้องแสดงว่ากรณีใดดีขึ้น กรณีใดแย่ลง และการเปลี่ยนแปลงมีต้นทุนเท่าไร
ข้อกำหนดการประเมินของเรามีหกขั้นตอน:
- ตรึงกรณีทดสอบและกฎการให้คะแนน กำหนดความสำเร็จของงานและข้อจำกัดทางธุรกิจที่ต้องปฏิบัติตามก่อนรันรุ่นที่ต้องการประเมิน
- จัดกลุ่มตัวอย่างที่เกี่ยวข้องกัน ให้แต่ละสถานการณ์สังเคราะห์และกรณีแปรผันอยู่ในชุดเดียวกัน กันกรณีที่เป็นอิสระไว้สำหรับการทดสอบสุดท้าย
- ระบุสิ่งที่เปลี่ยน บันทึกการเปลี่ยนพรอมป์ต์ เครื่องมือ การค้นคืนข้อมูล หรือระบบรันเอเจนต์ที่กำลังทดสอบ
- คืนสถานะเริ่มต้นก่อนทุกครั้งที่ลอง การตั้งค่าทั้งสองแบบต้องได้รับเวลานัดหมายที่ว่าง ระเบียน และสิทธิ์ชุดเดียวกัน
- ทดสอบซ้ำภายในงบประมาณที่กำหนด รายงานจำนวนครั้ง ช่วงความเชื่อมั่น และผลต่างของผลลัพธ์แบบจับคู่ โดยคำนึงถึงการรันซ้ำจากกรณีเดียวกัน
- ตรวจผลที่แย่ลงก่อนปล่อยรุ่นใหม่ ทบทวนความล้มเหลวแยกตามเวิร์กโฟลว์ ภาษา และประเภทการดำเนินการ รวมถึงกรณีที่ harness เดิมจัดการได้ถูกต้อง
รักษาลำดับเหตุการณ์ในการจำลองแต่ละครั้ง ณ จุดตัดสินใจ โมเดลได้รับเฉพาะข้อมูลที่มีอยู่ในขั้นตอนนั้น คำตอบที่คาดหวัง ข้อความจำลองที่เกิดภายหลัง และสถานะธุรกรรมสุดท้าย เป็นข้อมูลสำหรับการตรวจของตัวประเมิน
ตัวชี้วัดที่บอกว่าการปรับปรุงช่วยงานจริงหรือไม่
| ตัวชี้วัด | นิยาม | ประโยชน์ทางวิศวกรรม |
|---|---|---|
| ความสำเร็จของงานที่ตรวจสอบแล้ว | จำนวนครั้งที่ได้ผลลัพธ์ตามเกณฑ์ที่ระบุ หารด้วยจำนวนครั้งทั้งหมดที่เข้าเกณฑ์การประเมิน | ตัววัดประสิทธิผลหลัก |
| การละเมิดข้อจำกัดที่ต้องปฏิบัติตาม | จำนวนครั้งที่มีการดำเนินการต้องห้าม หารด้วยจำนวนครั้งที่เข้าเกณฑ์ | เกณฑ์ตัดสินก่อนปล่อยรุ่นใหม่ |
| การอ้างว่างานเสร็จโดยไม่มีหลักฐาน | จำนวนคำกล่าวอ้างการดำเนินการที่ตรวจแล้วไม่มีสถานะหรือหลักฐานยืนยัน หารด้วยจำนวนคำกล่าวอ้างที่ตรวจทั้งหมด | วัดความล้มเหลวด้านความน่าเชื่อถือประเภทหนึ่ง |
| อัตราข้อผิดพลาดของเครื่องมือ | จำนวนการเรียกเครื่องมือที่ล้มเหลว หารด้วยจำนวนครั้งที่พยายามเรียก แยกตามประเภทข้อผิดพลาด | แยกความล้มเหลวด้านอินเทอร์เฟซ นโยบาย และโครงสร้างพื้นฐาน |
| การแทรกแซงโดยเจ้าหน้าที่ | จำนวนครั้งที่ต้องให้ผู้ดูแลแก้ไขหรือรับช่วงงาน หารด้วยจำนวนครั้งที่เข้าเกณฑ์ | วัดภาระการดำเนินงาน |
| เวลาแฝง p50, p95 และ p99 | ระยะเวลาตั้งแต่ต้นจนจบ โดยบันทึกเวลารอคิวและเวลาของผู้ให้บริการแยกกัน | แสดงพฤติกรรมทั้งกรณีทั่วไปและกรณีที่ใช้เวลานาน |
| ต้นทุนต่อความสำเร็จที่ตรวจสอบแล้ว | ต้นทุนที่วัดได้รวมทุกครั้ง หารด้วยจำนวนความสำเร็จที่ตรวจสอบแล้ว | รวมต้นทุนของครั้งที่ล้มเหลวด้วย |
| ความครอบคลุมของหลักฐาน | จำนวนครั้งที่มีข้อมูลสังเกตการณ์ครบตามที่กำหนด หารด้วยจำนวนครั้งที่นับด้วยวิธีอิสระ | บอกว่ารายงานมีหลักฐานรองรับข้อสรุปได้มากเพียงใด |
กำหนดเกณฑ์การนับก่อนเริ่มดำเนินการ การหมดเวลารอ ข้อผิดพลาดจากผู้ให้บริการ และบันทึกการทำงานที่ไม่ครบยังต้องอยู่ในจำนวนครั้งที่ลอง กรณีที่ยังรอผลและไม่ทราบผลต้องแสดงไว้ แยกการไม่มีข้อมูลการใช้งานออกจากค่าใช้จ่ายที่วัดได้ รายงานที่ตัดครั้งที่ล้มเหลวออกจากตัวหารอาจทำให้ harness ที่ช้าลงหรือเชื่อถือได้น้อยลงดูดีขึ้น
คะแนนรวมต้องมีผลแยกตามกลุ่มด้วย การปรับปรุงการจองที่ทำให้การส่งต่อเรื่องแย่ลงอาจถูกกลบด้วยค่าเฉลี่ยรวม กลุ่มภาษาที่มีปริมาณมากอาจซ่อนผลที่แย่ลงในกลุ่มเล็ก รายงานก่อนปล่อยรุ่นใหม่ควรคงรายละเอียดแยกเหล่านี้ไว้
6. ประสิทธิภาพและพื้นที่จัดเก็บเป็นส่วนหนึ่งของการออกแบบ
การปรับปรุง harness ใช้ทรัพยากร บริบทที่มากขึ้นเพิ่มโทเค็นขาเข้า รอบการใช้เครื่องมือที่มากขึ้นเพิ่มเวลาแฝงและโอกาสเกิดความล้มเหลว บันทึกการประเมินโดยละเอียดเพิ่มการเขียนข้อมูลและต้นทุนพื้นที่จัดเก็บ การประเมินแบบออฟไลน์ใช้งบประมาณผู้ให้บริการและกำลังประมวลผลของเวิร์กเกอร์ ต้นทุนเหล่านี้ต้องอยู่ในการทบทวนทางวิศวกรรมเดียวกับความสำเร็จของงาน
ข้อกำหนดด้านประสิทธิภาพระบุจุดดำเนินการและเพดานต้นทุนสำหรับงานแต่ละประเภท:
| งาน | จุดดำเนินการ | การควบคุมต้นทุน |
|---|---|---|
| การตรวจสิทธิ์ เงื่อนไขล่วงหน้า และการอนุมัติที่จำเป็น | ก่อนการดำเนินการที่เกี่ยวข้อง | ตรวจสถานะอย่างกระชับผ่านข้อมูลที่มีดัชนี |
| ตัวนับการทำงาน ระยะเวลา และรหัสข้อผิดพลาด | ณ จุดตรวจที่กำหนดในระบบรันเอเจนต์ | จำกัดฟิลด์และเวลาในการบันทึก |
| บันทึกรายละเอียดของการประเมินด้วยข้อมูลสังเคราะห์ | การรันประเมินที่เลือกไว้ | สุ่มเก็บและกำหนดงบประมาณไบต์ต่อการรัน |
| การสร้างกรณีสังเคราะห์และวิเคราะห์ผลทดสอบ | งานประเมินเบื้องหลัง | จำกัดขนาดชุดงาน จำนวนงานพร้อมกัน และค่าใช้จ่าย |
| การเปรียบเทียบรุ่นที่ต้องการประเมิน | การรันประเมินในสภาพแวดล้อมแยก | กำหนดงบประมาณจำนวนกรณี จำนวนรอบซ้ำ และเวลา |
การเก็บข้อมูลการทำงานส่วนที่เป็นทางเลือกต้องมีเวลาสิ้นสุดชัดเจน การดักจับข้อผิดพลาดฐานข้อมูลไม่ได้ป้องกันการเชื่อมต่อที่ช้าหรือการรอล็อกไม่ให้หน่วงคำตอบถึงลูกค้า ส่วนบันทึกการตรวจสิทธิ์และการอนุมัติที่จำเป็นมีข้อกำหนดต่างออกไป: เมื่อบันทึกเหล่านี้ล้มเหลว ต้องหยุดการดำเนินการที่พึ่งพาบันทึกนั้น
ตัวนับการทำงานในข้อกำหนดนี้วัดระยะเวลา สถานะ และการใช้ทรัพยากร ส่วนบันทึกการประเมินด้วยข้อมูลสังเคราะห์เก็บรายละเอียดข้อมูลนำเข้าและผลลัพธ์ของการทดสอบ ประมาณพื้นที่จัดเก็บได้จากปริมาณการประเมินและขนาดหลักฐานที่เก็บ:
Daily evaluation evidence volume
  = recorded evaluation runs per day
  x mean retained bytes per recorded run
ค่าใช้จ่ายของดัชนี การทำสำเนา และการสำรองข้อมูลต้องบวกเพิ่มจากค่าประมาณนี้ การสุ่มเก็บตามสถานการณ์ก็ต้องวัดเช่นกัน สถานการณ์ที่ยาวเพียงส่วนน้อยอาจคิดเป็นสัดส่วนมากของการเรียกเครื่องมือและจำนวนไบต์ที่เก็บ
ภาพสถานะบริบทการประเมินที่ซ้ำกันควรได้รับการพิจารณาเป็นพิเศษ รอบหลังมักมีข้อความสังเคราะห์และผลลัพธ์เครื่องมือจากรอบก่อนซ้ำอยู่ การเก็บชิ้นส่วนที่แก้ไขไม่ได้พร้อมรายการอ้างอิงตามลำดับช่วยลดข้อมูลซ้ำได้ โดยต้องยังประกอบกลับและจัดการเวอร์ชันของชุดข้อมูลทดสอบได้อย่างเชื่อถือได้
7. ข้อจำกัดของวิศวกรรม harness
Harness สามารถเติมข้อเท็จจริงที่ขาดไป ทำให้การดำเนินการที่เรียกใช้ได้ชัดเจนขึ้น และป้องกันการเขียนข้อมูลที่ไม่ถูกต้อง ความล้มเหลวบางอย่างยังคงอยู่แม้แก้ไขเรื่องเหล่านี้แล้ว เราแยกปัญหาดังกล่าวออกเป็นประเภท: ข้อกำหนดงานที่กำกวม ข้อมูลธุรกิจที่ขาดหาย การเชื่อมต่อที่ใช้งานไม่ได้ และความล้มเหลวในการให้เหตุผลทั้งที่มีบริบทเพียงพอและเครื่องมือทำงานได้ วิธีแก้ขึ้นอยู่กับประเภทของปัญหา
เกณฑ์เปรียบเทียบที่เผยแพร่ก็มีขอบเขต งานเขียนโค้ด การตอบคำถาม และการทำงานอัตโนมัติผ่านแอปพลิเคชันใช้เกณฑ์ความสำเร็จต่างกัน เวิร์กโฟลว์ธุรกิจของเรามีนโยบายแยกตามองค์กร การตัดสินใจของเจ้าหน้าที่ และระบบภายนอกที่สถานะเปลี่ยนตามเวลาเพิ่มเข้ามา การทดลองเหล่านี้ยืนยันว่าการเปลี่ยน harness ส่งผลได้มาก ส่วนผลที่เพิ่มขึ้นสำหรับเวิร์กโฟลว์ใดต้องวัดด้วยการประเมินที่ตรงกับสภาพการนำไปใช้งาน
การปล่อยรุ่นขึ้นระบบใช้งานจริงจึงต้องมีทั้งหลักฐานผลลัพธ์และหลักฐานการดำเนินงาน งานต้องสำเร็จภายใต้กฎที่ระบุ และต้นทุน เวลาแฝง ตลอดจนพฤติกรรมเมื่อเกิดความล้มเหลวต้องเหมาะกับบริการที่รองรับ
บทสรุป
วิศวกรรม harness ทำให้เรามีจุดปรับปรุงเอเจนต์ที่ชัดเจน ได้แก่ ข้อเท็จจริงที่ได้รับ ขั้นตอนที่ปฏิบัติตาม การดำเนินการที่ขอได้ และการตรวจสอบรอบการดำเนินการเหล่านั้น StaffOS ใช้โครงสร้างนี้รองรับการตั้งค่าทางธุรกิจที่ผ่านการตรวจทานและการควบคุมการทำงานที่ระบุชัดเจน
สำหรับการเปลี่ยนแปลงแต่ละครั้ง ระเบียบวิธีประเมินระบุความล้มเหลว จำลองการตัดสินใจนั้นในกรณีที่ควบคุมได้ และเปรียบเทียบ harness รุ่นที่ปรับแล้วโดยคงโมเดลเดิม การตัดสินใจปล่อยรุ่นใหม่พิจารณาทั้งความสำเร็จ ผลที่แย่ลง เวลาแฝง และต้นทุน กรณีนั้นจะยังอยู่ในชุดประเมินเพื่อให้ตรวจพบความล้มเหลวเดิมได้อีก
ผู้เขียนและการอ้างอิง
Vin Lim เป็นประธานเจ้าหน้าที่ฝ่ายเทคโนโลยี (CTO) ของ StaffOS ทำงานด้านการประสานการทำงานของเอเจนต์ การเชื่อมต่อระบบธุรกิจ การจัดการบริบท และการประเมิน
รูปแบบการอ้างอิงที่แนะนำ: Lim, V. (2026). Agent harness engineering: improving AI without fine-tuning. StaffOS technical paper, version 1.1, September 17. https://staffos.xyz/blog/agent-harness-engineering
ดาวน์โหลดรายการอ้างอิง BibTeX · ดาวน์โหลดข้อมูลเกณฑ์เปรียบเทียบและ URL แหล่งที่มา · รูปที่ 1 ในรูปแบบ SVG · รูปที่ 2 ในรูปแบบ SVG


กราฟแสดงค่าที่คัดเลือกจากงานวิจัยที่เผยแพร่แล้ว ผลต่างในหน่วยจุดเปอร์เซ็นต์คำนวณด้วยการลบ ส่วนอัตราส่วนการแก้โจทย์สำเร็จคำนวณด้วยการหาร กราฟไม่ได้รวมผลข้ามเกณฑ์เปรียบเทียบ สำหรับบริบททางธุรกิจ อ่านบทความของเราเรื่องการคัดกรองลีดและงานวิจัยเรื่องเวลาตอบลีด
Frequently asked questions
Agent harness คืออะไร? +
Agent harness คือซอฟต์แวร์ที่รวบรวมบริบทให้โมเดล จัดเตรียมเครื่องมือ ดำเนินการตามคำขอ จัดการสถานะ และกำหนดว่างานเสร็จเมื่อใด รวมถึงจัดเตรียมบันทึกและขั้นตอนการประเมินที่จำเป็นต่อการปรับปรุงพฤติกรรมเหล่านี้
เอเจนต์ทำงานได้ดีขึ้นโดยไม่ทำ fine-tuning ได้หรือไม่? +
ได้ การเปลี่ยนคำสั่ง การค้นคืนข้อมูล ข้อกำหนดการทำงานของเครื่องมือ หน่วยความจำ หรือกฎการดำเนินงาน ช่วยเพิ่มอัตราการทำงานสำเร็จได้โดยคงน้ำหนักของโมเดลที่ใช้งานไว้เท่าเดิม ผลที่เพิ่มขึ้นขึ้นอยู่กับโมเดล เวิร์กโฟลว์ และ harness ที่ใช้เป็นฐานเปรียบเทียบ
การพัฒนา harness จำเป็นต้องฝึกโมเดลด้วยข้อมูลลูกค้าหรือไม่? +
แนวทางที่อธิบายในบทความนี้คงน้ำหนักโมเดลไว้เท่าเดิม วิศวกรปรับคำสั่ง อินเทอร์เฟซเครื่องมือ และกฎการดำเนินงาน แล้วประเมินการเปลี่ยนแปลงด้วยกรณีทดสอบเวิร์กโฟลว์ที่สร้างขึ้น บทความนี้ใช้ผลวิจัยที่เผยแพร่ต่อสาธารณะและตัวอย่างสมมติ ไม่มีบทสนทนาของลูกค้าหรือระเบียนข้อมูลผู้ใช้
การประเมิน harness ควรวัดอะไรบ้าง? +
วัดความสำเร็จของงานที่ตรวจสอบแล้ว การละเมิดนโยบาย การอ้างว่างานเสร็จโดยไม่มีหลักฐาน ข้อผิดพลาดของเครื่องมือ การแทรกแซงโดยเจ้าหน้าที่ เวลาแฝง และต้นทุนต่อความสำเร็จที่ตรวจสอบแล้ว เมื่อต้องการวัดผลของการเปลี่ยน harness ให้คงโมเดลและเงื่อนไขการประเมินไว้เหมือนเดิม
References
- [1] Kim, M., et al. FrogNano: Training a 4B Coding Agent via Online Task Synthesis. arXiv:2609.07925v3, 2026. Section 2.
- [2] Agrawal, L. A., et al. GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. arXiv:2507.19457v2, 2026. Table 1.
- [3] Zhang, Q., et al. Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models. arXiv:2510.04618v3, 2026. Table 1.
- [4] ผู้เขียน GEPA การตั้งค่าการทดลอง HotpotQA และตัวประเมินแบบ exact match อย่างเป็นทางการ
About the author
Vin Lim
ผู้ร่วมก่อตั้ง / CTO, StaffOS
Vin Lim เป็น CTO ของ StaffOS รับผิดชอบการประสานการทำงานของเอเจนต์ การเชื่อมต่อระบบธุรกิจ การจัดการบริบท และระบบที่ใช้ประเมินและปรับปรุงเอเจนต์ AI
Related reading
สถิติเวลาตอบลีดจากทุกงานวิจัยสำคัญ ตั้งแต่ปี 2007 ถึง 2026
บทความส่วนใหญ่อ้างงานวิจัยเรื่องเวลาตอบลีดด้วยที่มาที่ผิด เราตรวจสอบทุกงานวิจัยสำคัญตั้งแต่ปี 2007 ถึง 2026 ใหม่ เทียบกับเปเปอร์ต้นฉบับจริง
Speed-to-lead ในยุคของเอเจนต์: เส้นโค้งจาก HBR ยังจริง แต่ตอนนี้พื้นวัดกันที่หลักวินาที
เส้นโค้ง speed-to-lead จาก HBR ปี 2011 ยังจริงอยู่ แต่ค่ามัธยฐานการตอบลีดในอุตสาหกรรมกลับแย่ลง นี่คือสิ่งที่ AI SDR เปลี่ยน และเหตุผลที่พื้นใหม่วัดกันที่หลักวินาที
เอเจนต์ AI ทำให้ drip cadence ล้าสมัยไปแล้ว การหล่อเลี้ยงตามสัญญาณคือสิ่งที่มาแทน
drip cadence ถูกสร้างขึ้นในยุคที่การปรับให้เป็นส่วนตัวมีต้นทุนสูงและการส่งข้อความแทบไม่มีต้นทุน LLM พลิกเศรษฐศาสตร์นั้นกลับด้าน นี่คือเหตุผลสำหรับการหล่อเลี้ยงตามสัญญาณในยุคของเอเจนต์